香港GPU服务器面向东南亚用户:如何根据运营商和跨境路径判断部署位置
本文介绍如何按东南亚用户所在国家、接入运营商、业务类型与跨境访问路径,评估香港GPU服务器是否适合作为统一算力入口,并提供样本准备、分阶段测试、日志验证、关键配置、异常排查及灰度回滚方法,适合负责业务部署、采购与成本决策的企业用户。
先确定:香港GPU服务器是否适合作为东南亚统一入口
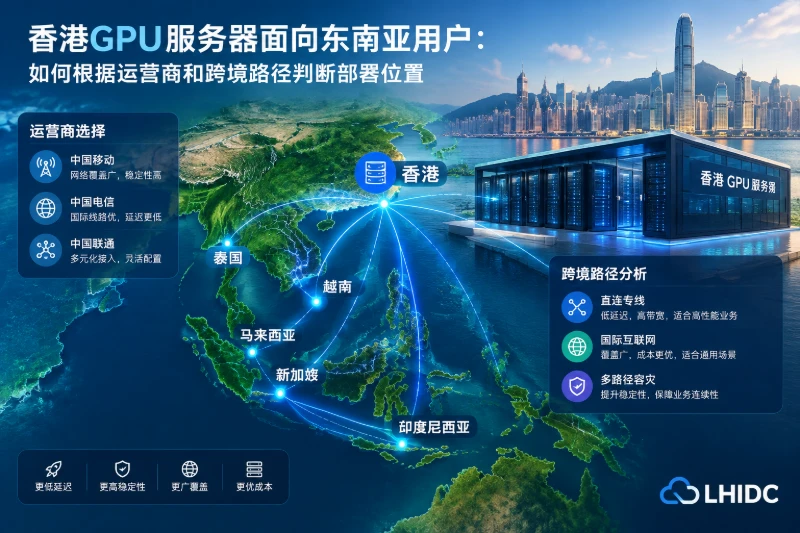
面向东南亚用户部署香港GPU服务器,不能只看“香港距离较近”,而应判断用户所在国家、当地运营商出口,以及访问流量实际经过的跨境路径。香港更适合承担东南亚多国用户的统一推理、渲染、AI API 或后台计算入口;但如果用户高度集中在某一国家、业务对实时交互极其敏感,仅部署在香港未必是最优方案。
判断逻辑可以简化为:先按用户国家和运营商分组,再验证各组到香港的实际访问路径,最后根据业务是否允许网络波动决定是否集中部署。 对GPU业务而言,模型推理速度、显存和算力只解决服务器端处理时间;用户感受到的响应速度还包含跨境连接建立、请求上传、结果回传和长连接稳定性。
开始前需要准备的访问样本
部署位置判断不能依赖办公室网络或单一测速点。应尽量从真实用户网络、当地合作方网络或云探针中收集样本,并按国家与运营商记录。
建议至少整理以下信息:
- 用户主要分布国家,例如新加坡、马来西亚、泰国、越南、印度尼西亚、菲律宾等
- 每个国家的用户占比,而不是仅记录注册用户所在地
- 用户接入方式,例如家庭宽带、移动网络、企业专线、云服务器
- 当地主流运营商或企业出口运营商
- 业务请求类型,例如网页AI对话、图片生成、视频处理、远程桌面、游戏云渲染
- 单次请求的数据量,包括上传图片、音频、视频或模型文件的大小
- 是否使用WebSocket、HTTP/2、HTTPS长连接或实时音视频协议
- 当前业务是否已有其他节点,以及DNS、负载均衡和应用入口配置
尤其要区分“用户来源地区”和“访问网络归属”。例如,用户人在泰国,但通过跨国企业VPN访问;或者用户在印尼,却使用国际云服务出口。这类流量的实际路径可能与普通本地宽带完全不同。
用业务特征判断香港集中部署是否合适
不同GPU业务对跨境路径的敏感度不同。不能用同一套标准判断所有场景。
| 业务类型 | 对跨境路径的敏感度 | 香港集中部署的适用条件 | 需要重点观察的指标 |
|---|---|---|---|
| AI文本问答、知识库检索 | 较低 | 用户分布在多个东南亚国家,单次请求数据量较小 | 首次响应时间、长连接断开率、接口错误率 |
| 图片生成、批量推理 | 中等 | 用户可接受任务排队和异步返回,上传文件体积可控 | 上传成功率、任务提交耗时、下载稳定性 |
| 视频生成、音视频AI处理 | 较高 | 采用对象存储直传、异步任务和结果通知机制 | 大文件上传速度、断点续传、回调成功率 |
| 云渲染、远程GPU桌面 | 很高 | 用户分布较广但交互要求未达到本地化水平 | 抖动、丢包、会话中断、输入响应连续性 |
| 实时音视频增强、互动直播 | 很高 | 已确认主要运营商到香港路径稳定 | 长连接质量、上行稳定性、重连频率 |
如果业务采用“提交任务—后台GPU处理—完成后下载结果”的模式,香港GPU服务器通常更容易作为集中算力节点。因为用户对瞬时网络波动的容忍度较高,应用可以通过队列、重试、断点续传和异步通知减少路径波动影响。
如果业务是远程桌面、实时渲染、在线协作或连续音视频处理,则应更谨慎。此类业务不只受平均延迟影响,还会受到抖动、短时丢包、运营商国际出口拥塞和跨境路由切换影响。
按“国家—运营商—业务类型”建立判断表
不要直接问“东南亚访问香港快不快”,应把问题拆成可执行的分组判断。建议创建一份部署评估表,先记录业务事实,再补充网络验证结果。
| 用户分组 | 用户占比 | 常见接入网络 | 主要业务行为 | 对网络波动容忍度 | 建议部署判断 |
|---|---|---|---|---|---|
| 国家A的移动网络用户 | 待统计 | 4G、5G | 移动端AI问答、图片上传 | 中等 | 先验证移动网络到香港的HTTPS与WebSocket稳定性 |
| 国家A的企业用户 | 待统计 | 企业宽带、VPN、专线 | API调用、批量推理 | 中等 | 检查企业出口是否绕行或经安全网关 |
| 国家B的家庭宽带用户 | 待统计 | 固网宽带 | 图片生成、结果下载 | 中等 | 检查上传与下载方向是否存在明显差异 |
| 多国分散用户 | 待统计 | 多运营商混合 | 异步GPU任务 | 较高 | 香港可作为统一算力中心,需配合任务队列和对象存储 |
这里的关键不是填写精确数值,而是找出占比最高、投诉风险最高和业务价值最高的用户组。若某一个国家或某一家运营商贡献了大部分实时交互流量,应单独进行路径验证,不能被其他国家的良好表现掩盖。
分阶段验证跨境访问路径
部署前建议按“低风险验证—小流量试运行—正式切换”推进,而不是一次性将所有用户入口切到香港GPU服务器。
第一阶段:检查香港节点的服务入口
先确认GPU服务已经具备可观测性。至少应提供一个不依赖GPU任务的健康检查接口,以及一个能够验证GPU任务链路的测试接口。
例如,可在应用网关中设置基础健康检查路径:
location = /healthz {
    access_log off;
    add_header Content-Type text/plain;
    return 200 "ok\n";
}
如果应用使用Nginx反向代理,修改配置前应先备份现有文件,并检查语法后再重载服务:
sudo cp /etc/nginx/nginx.conf /etc/nginx/nginx.conf.backup.$(date +%F-%H%M%S)
sudo nginx -t
sudo systemctl reload nginx
执行前应确认系统使用的是systemd,并核对Nginx配置实际路径。部分环境会将站点配置放在/etc/nginx/conf.d/或/etc/nginx/sites-enabled/目录中。
健康检查只能证明入口服务可达,不能证明GPU推理链路正常。因此还应准备一个权限受控的测试任务,例如提交固定文本或小尺寸测试图片,并确认应用能返回任务ID、处理状态和结果地址。
第二阶段:从目标运营商发起真实访问
在每个重点国家和运营商网络中,分别验证以下内容:
- HTTPS访问是否能稳定完成DNS解析、TLS握手和接口请求。
- 上传文件时是否出现中断、超时或重复提交。
- WebSocket或长轮询连接是否频繁重连。
- GPU任务提交后,结果回调、查询和下载是否完整。
- 同一运营商在不同时间段是否出现明显路径变化。
客户端可先使用curl验证基础HTTP链路。以下命令不会修改服务器配置,适合作为基础检查:
curl -I --connect-timeout 10 --max-time 30 https://example.com/healthz
如需观察请求各阶段耗时,可使用:
curl -o /dev/null -sS \
  --connect-timeout 10 \
  --max-time 60 \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s first_byte=%{time_starttransfer}s total=%{time_total}s http=%{http_code}\n' \
  https://example.com/healthz
将example.com替换为实际业务域名。不要让客户端直接暴露管理端口、GPU管理接口或内部服务地址。
如果ICMP被运营商或防火墙限制,ping和部分mtr结果可能没有参考价值。此时应以真实HTTPS、WebSocket、上传和任务完成率为主,而不是仅依据路由追踪输出判断。
第三阶段:观察服务器侧日志和资源状态
跨境路径问题通常会在应用层表现为超时、客户端提前断开、上传中断或长连接异常。因此要同时查看网关日志、应用日志和GPU服务日志。
Nginx环境可先检查访问与错误日志是否出现集中异常:
sudo tail -n 100 /var/log/nginx/access.log
sudo tail -n 100 /var/log/nginx/error.log
重点关注以下现象:
- 同一国家或运营商来源出现大量
499,通常表示客户端在服务端返回前主动断开。 - 出现
504时,需要进一步区分是GPU推理耗时过长、上游应用无响应,还是代理超时设置过短。 - 上传接口频繁出现请求体不完整,可能与移动网络切换、跨境路径波动或客户端重试策略有关。
- WebSocket连接大量重连时,应同时检查代理超时、应用心跳和客户端网络切换情况。
GPU服务本身也要确认没有因显存不足、任务堆积或进程退出造成假性网络问题。若系统已安装相应驱动工具,可查看GPU运行状态:
nvidia-smi
该命令适用于已正确安装NVIDIA驱动和工具链的环境。若命令不存在,应先核对驱动安装状态,不应直接假设服务器使用特定GPU或特定驱动版本。
将网络判断转化为部署方案
经过分组验证后,通常会形成三种部署决策。
多国用户分散,且业务以异步GPU任务为主
可将香港GPU服务器作为集中计算节点,但应用设计应减少用户与GPU主机之间的大文件直接交互。
更稳妥的方式是:
- 用户先上传到对象存储或文件服务入口。
- 应用仅向GPU任务队列传递文件地址、任务参数和回调信息。
- GPU服务器完成推理后写回结果存储。
- 用户通过业务域名查询任务状态或下载结果。
这样即使部分跨境路径短时波动,也不会直接中断GPU计算任务。
某一国家用户占比较高,但运营商路径差异明显
不要因为一条网络表现正常,就默认整个国家都适合香港部署。应根据运营商分别判断。
例如,企业专线用户、移动网络用户和家庭宽带用户可能走不同出口。此时可保留香港GPU算力中心,但通过DNS调度、应用入口、静态资源分发或上传中转,将高频交互流量与大文件流量拆开处理。
判断重点是:算力中心可以集中,用户入口不一定必须完全相同。
实时交互业务集中在单一国家或少数运营商
如果远程GPU桌面、互动渲染或实时媒体处理用户集中在单一市场,并且测试中持续出现抖动、重连或输入反馈不连续,则香港集中部署的边界已经比较明确。
这类场景不宜仅靠增加GPU规格解决。GPU性能提升只能缩短服务端处理时间,不能修复用户到香港之间的跨境路由波动。应重新评估更接近核心用户群的接入节点、边缘入口或区域化部署策略。
上线前的关键配置检查
正式开放前,应确认应用层已经具备处理跨境网络波动的能力。
- 上传接口支持分片上传、断点续传或幂等请求ID,避免用户重试导致重复创建GPU任务。
- GPU任务通过队列执行,避免客户端连接断开后任务直接丢失。
- API返回任务ID和可查询状态,不要求用户持续保持单一HTTP连接。
- 长连接配置了心跳机制,客户端能够识别断线并安全重连。
- 反向代理的读取超时应覆盖正常GPU任务响应时间,但不能无限扩大,以免异常任务长期占用连接。
- 日志中应记录请求时间、任务ID、出口状态码和上游错误类型,便于区分网络问题与GPU服务问题。
- DNS切换前应保留原入口、原解析记录和旧版本配置备份。
如果使用灰度域名,可先让内部员工、合作方或部分目标国家用户访问新入口。观察一段完整业务周期后,再逐步扩大解析范围。切换过程中不应同时修改域名解析、GPU服务版本、模型版本和反向代理规则,否则出现问题后难以定位原因。
出现异常时的检查顺序
当部分东南亚用户反馈“访问香港GPU服务器慢”或“任务经常失败”时,建议按以下顺序排查:
- 确认问题是否集中在某个国家、运营商、网络类型或时间段。
- 检查健康检查接口是否正常,排除全站入口故障。
- 检查应用任务队列是否堆积,确认不是GPU处理能力不足。
- 检查Nginx和应用日志,区分客户端断开、代理超时和上游报错。
- 从受影响运营商网络复现HTTPS请求、上传和任务查询流程。
- 比较同一业务在其他运营商、其他国家或企业网络下的表现。
- 仅当问题确实集中于跨境路径时,再调整流量入口、上传路径或节点策略。
不要在尚未确认原因时直接扩大超时、关闭防火墙或反复重启GPU服务。此类操作可能掩盖问题,并影响正常用户。
触发回滚的条件
灰度切换到香港GPU服务器后,如出现以下情况,应停止扩大流量并回滚到原入口或原解析方案:
- 重点国家或重点运营商的任务提交失败持续增加。
- 健康检查正常,但真实GPU任务大量超时、重复提交或无法下载结果。
- 应用日志出现持续新增的上游连接错误、任务队列异常或客户端集中断开。
- 用户侧无法稳定完成上传、WebSocket连接或任务状态查询。
- 问题只在新入口出现,而原入口仍可正常完成同类操作。
回滚前应保留切换期间的访问日志、应用错误日志、任务队列状态和用户反馈时间段。恢复旧入口后,再按国家、运营商和业务类型拆分样本复查,避免把单一运营商的短时波动误判为香港GPU服务器整体不适用。