openEuler服务器为何能自动恢复服务:systemd依赖与重启机制解析
解析openEuler服务器通过systemd跟踪进程状态、匹配重启策略并协调单元依赖实现服务恢复的原理,说明Restart参数、启动频率限制、依赖关系、配置检查与故障验证方法,帮助运维人员判断自动恢复的条件及边界。
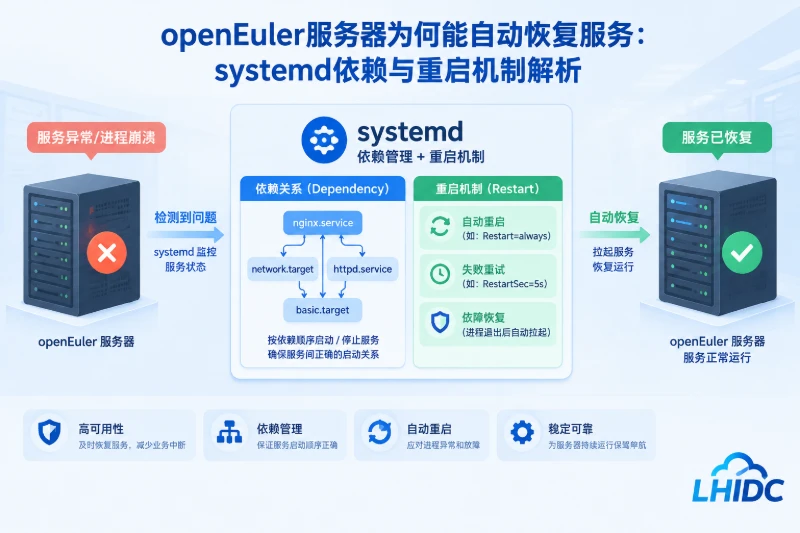
看到服务处于 enabled 状态,或者配置了 Restart=on-failure,并不等于业务一定能够自动恢复。enabled 主要解决开机时是否拉起服务,Restart= 决定进程退出后是否重启,而 After=、Requires= 等依赖项负责启动顺序和单元关联。只有这些机制与应用自身的启动方式、退出状态、就绪条件相匹配,自动恢复才会真正发生。
openEuler服务器能够在进程异常后恢复服务,核心原因是 systemd 作为 PID 1 持续管理服务单元:它跟踪主进程状态,根据退出原因匹配重启策略,在重启频率限制内重新执行 ExecStart,并按照依赖关系安排相关单元。但 systemd 默认并不会检测网页是否能访问、数据库查询是否正常,也不会因为写了依赖关系就自动修复所有故障。
“开机自启”与“故障恢复”不是一回事
判断自动恢复能力时,首先要区分三个容易混淆的机制。
| 机制 | 典型配置 | 主要作用 | 不能解决的问题 |
|---|---|---|---|
| 开机激活 | systemctl enable、WantedBy= |
让服务随指定 target 启动 | 运行中进程退出后是否重启 |
| 进程重启 | Restart=、RestartSec= |
根据退出原因重新启动服务 | 进程存活但业务不可用 |
| 单元依赖 | After=、Wants=、Requires= |
安排启动顺序和关联动作 | 端口、接口、数据库内容等业务健康检查 |
例如,一个服务已经执行:
sudo systemctl enable myapp.service
这通常只是创建指向目标单元的符号链接,使 myapp.service 在下次进入对应 target 时被拉起。如果应用启动后崩溃,而单元文件仍然是默认的 Restart=no,systemd 会将其置为 failed,不会仅仅因为它是 enabled 状态就再次启动。
反过来,一个未启用开机自启、但已由管理员手动启动的服务,只要配置了合适的 Restart=,运行期间发生异常退出仍可能被 systemd 拉起。因此,检查 openEuler服务器的恢复能力不能只看 systemctl is-enabled。
systemd如何判断一个服务已经失败
systemd管理的对象是“单元”,服务对应 .service 单元。它会根据 Type=、ExecStart= 和进程关系确定哪个进程代表服务,并观察该进程如何退出。
常见服务类型对判断结果有直接影响:
Type=simple:通常将ExecStart启动的进程视为主进程,适合以前台方式运行的应用。Type=forking:应用启动后会派生后台进程,父进程退出。此时最好提供可靠的PIDFile=,否则主进程识别可能不准确。Type=notify:应用通过 systemd 通知机制报告启动完成,也可以配合 watchdog 发送存活通知。Type=oneshot:用于执行一次性任务,不适合直接套用普通常驻服务的重启思路。
如果 ExecStart 调用的是一层Shell脚本,而脚本启动后台程序后立即以状态码0退出,systemd可能认为任务已经正常结束,却无法持续监督真正的业务进程。要让自动恢复可靠,常驻应用通常应以前台模式运行,并由 systemd直接跟踪主进程,而不是再套一层自行守护和后台化逻辑。
服务异常后,可以先查看 systemd记录的结果:
systemctl status myapp.service --no-pager -l

systemctl show myapp.service \
  -p ActiveState \
  -p SubState \
  -p Result \
  -p MainPID \
  -p ExecMainCode \
  -p ExecMainStatus
常见结果包括:
Result=exit-code:主进程以非零状态码退出。Result=signal:进程因信号终止。Result=timeout:启动、停止或运行过程触发超时。Result=watchdog:服务未按要求发送 watchdog 通知。Result=start-limit-hit:短时间启动次数超过限制,systemd停止继续尝试。
这些结果决定了 Restart= 是否匹配本次故障。
Restart参数如何变成实际恢复行为
Restart= 不是简单的开关,而是对退出原因进行分类。常用取值及影响如下。
| 配置 | 触发范围 | 适合场景 |
|---|---|---|
Restart=no |
不自动重启 | 一次性任务,或必须人工确认后恢复的服务 |
Restart=on-failure |
非正常退出、信号、超时等失败情况 | 大多数常驻服务的常用选择 |
Restart=on-abnormal |
信号、超时、watchdog等异常终止 | 希望保留正常退出行为的服务 |
Restart=on-watchdog |
watchdog超时 | 已接入systemd watchdog的应用 |
Restart=always |
正常或异常退出后都尝试重启 | 理论上不应自行退出的常驻进程 |
即使使用 Restart=always,通过 systemctl stop 发起的明确停止操作通常也不会被当作需要自动恢复的故障,否则管理员将无法正常停止服务。
对于 Restart=on-failure,进程返回0通常表示正常结束,不会触发重启。如果某个应用使用特殊退出码表示“无需重启”或“可视为成功”,还可以结合以下参数细分:
[Service]
Restart=on-failure
SuccessExitStatus=2
RestartPreventExitStatus=3 4
这表示状态码2可以被视为成功,而状态码3、4即使属于失败,也不执行自动重启。具体退出码必须依据应用文档确定,不能直接照搬示例。
RestartSec决定恢复节奏
RestartSec= 表示一次失败后等待多长时间再尝试启动。它影响的不只是停机时间,还影响外部依赖和服务器负载。
设置过短可能导致:
- 配置错误时不断重复失败;
- 持续连接数据库或外部接口,放大依赖压力;
- 大量写入重复日志;
- 多个服务同时重启,形成资源争抢。
设置过长则会增加业务不可用时间。一次恢复所需时间可以近似理解为:
恢复时间 ≈ 故障发现时间 + RestartSec + 应用初始化时间 + 业务就绪时间
这个表达式不是固定性能数据。对于主进程直接退出的故障,systemd能较快观察到状态变化;对于进程仍在但内部已经死锁的故障,如果没有 watchdog 或外部健康检查,“故障发现时间”可能没有上限。
启动频率限制是自动恢复的熔断器
systemd不会允许服务无限高速重启。以下配置表示在一个时间窗口内限制启动次数:
[Unit]
StartLimitIntervalSec=60s
StartLimitBurst=5

[Service]
Restart=on-failure
RestartSec=5s
其业务含义是:如果服务在60秒内反复启动并达到限制,systemd会停止继续尝试,单元可能进入 start-limit-hit。这一机制能够防止重启风暴,但也意味着“配置了自动重启”不等于“会永久重试”。
不同openEuler版本所带的systemd版本可能存在参数名称或行为细节差异,修改前应先核对:
cat /etc/openEuler-release
systemctl --version
man systemd.service
man systemd.unit
遇到 start-limit-hit 时,应先修复配置、权限、依赖或资源问题,再清除失败状态并启动:
sudo systemctl reset-failed myapp.service
sudo systemctl start myapp.service
仅执行 reset-failed 不会消除导致服务反复退出的根因。
依赖关系决定启动链,但不等于业务健康
systemd依赖主要描述单元之间的启动、停止和排序关系。最常见的误区,是把 After= 理解成“必须等对方业务可用”。
例如:
[Unit]
Wants=network-online.target
After=network-online.target
After= 只规定当前单元排在 network-online.target 之后启动,Wants= 则尝试一并拉起该目标。但这不保证公网一定可达、DNS一定能解析,也不保证远程数据库已经接受连接。network-online.target 的实际意义还取决于系统所使用的网络管理组件及对应的 wait-online 服务。
应用如果依赖外部网络服务,仍应具备连接超时、有限重试和错误退避能力。
常见依赖项可以这样理解:
After=:只控制启动或停止作业的先后顺序,不负责拉起对方。Wants=:较弱的需求关系,对方失败时当前单元仍可能继续启动。Requires=:更强的启动关联,通常与After=配合,但并不代表对方始终健康。BindsTo=:比Requires=绑定更紧,常与After=配合,使当前单元更严格地跟随依赖单元的活动状态。PartOf=:将某个单元上的停止或重启动作传播到当前单元,但本身不建立启动顺序。OnFailure=:在单元最终进入失败状态时触发另一个单元,可用于告警或受控恢复动作。
假设应用必须在本地数据库单元启动后运行,通常至少要表达“拉起数据库”和“应用排在数据库后面”两个含义:
[Unit]
Requires=database.service
After=database.service
其中 database.service 只是示意名称,实际名称必须通过以下命令确认,不能根据软件名称猜测:
systemctl list-unit-files --type=service
systemctl list-dependencies myapp.service
systemctl list-dependencies --reverse database.service
即使数据库单元已经显示 active,也不等于数据库完成了数据恢复、账号验证和业务查询准备。因此,关键应用还应在自身启动逻辑中处理暂时不可用,而不是完全依赖 systemd排序。
检查openEuler服务器当前真正生效的配置
单元文件可能同时来自多个位置。软件包提供的文件通常位于 /usr/lib/systemd/system/,管理员配置一般位于 /etc/systemd/system/。后者中的完整单元或 drop-in 配置可以覆盖软件包默认值。
不要只打开某一个文件判断配置,应先让 systemd输出合并后的内容:
systemctl cat myapp.service
然后查看运行时生效参数:
systemctl show myapp.service \
  -p LoadState \
  -p ActiveState \
  -p SubState \
  -p Result \
  -p Restart \
  -p RestartUSec \
  -p NRestarts \
  -p StartLimitIntervalUSec \
  -p StartLimitBurst \
  -p Wants \
  -p Requires \
  -p After \
  -p BindsTo \
  -p PartOf
如果某个属性在当前systemd版本中不存在,应以本机 systemctl --version 和手册为准。
日志检查则应围绕最近一次失败时间展开:
journalctl -u myapp.service -b --since "-30 min" --no-pager
journalctl -b -p warning --no-pager
重点寻找以下信息:
- 主进程的退出码或终止信号;
- systemd是否输出
Scheduled restart job; - 当前重启计数;
- 是否达到启动频率限制;
ExecStart路径不存在或无执行权限;- 环境变量、工作目录、用户权限是否错误;
- 端口被占用或依赖服务连接失败;
- 内存不足、进程被终止等系统级异常。
如果问题只出现在开机阶段,还可以查看启动关键链:
systemd-analyze critical-chain myapp.service
它适合分析单元启动顺序和等待时间,但不能替代应用接口或端口健康检查。
用drop-in配置可控的自动恢复
不建议直接修改 /usr/lib/systemd/system/ 下的软件包文件,因为升级软件后可能被覆盖。更稳妥的方法是通过 drop-in覆盖少量参数。
修改前应记录现有配置,并备份已有覆盖目录:
sudo mkdir -p /root/systemd-backup

if [ -d /etc/systemd/system/myapp.service.d ]; then
  sudo cp -a /etc/systemd/system/myapp.service.d \
    "/root/systemd-backup/myapp.service.d.$(date +%F-%H%M%S)"
fi

systemctl cat myapp.service
随后编辑覆盖配置:
sudo systemctl edit myapp.service
可根据应用特性写入:
[Unit]
Wants=network-online.target
After=network-online.target
StartLimitIntervalSec=60s
StartLimitBurst=5

[Service]
Restart=on-failure
RestartSec=5s
TimeoutStartSec=30s
TimeoutStopSec=30s
这些数值只是配置方法示例,不应直接视为所有业务的推荐值。应用初始化时间超过 TimeoutStartSec 时,会被systemd判定启动超时;服务正常关闭所需时间超过 TimeoutStopSec 时,也可能被强制终止。
保存后重新加载单元配置:
sudo systemctl daemon-reload
systemctl cat myapp.service
执行重启会造成当前服务中断,应安排维护窗口,并确认上层是否有流量切换或会话保持要求:
sudo systemctl restart myapp.service
systemctl status myapp.service --no-pager -l
journalctl -u myapp.service -n 50 --no-pager
如需回滚,应恢复之前备份的 drop-in,再执行 daemon-reload 和受控重启。不要在未确认影响范围时直接使用 systemctl revert,因为它可能移除该单元的多项本地定制,而不仅是本次修改。
哪些故障无法靠Restart解决
自动重启适合处理“进程退出后重新启动即可恢复”的故障,不适合把所有异常都转化为循环重启。
进程存活,但业务已经失效
线程死锁、连接池耗尽、请求持续超时等情况下,主进程可能仍为 active (running)。systemd不会默认访问HTTP接口或执行数据库查询,因此不会触发 Restart=。
如果应用原生支持 sd_notify watchdog,可以结合 WatchdogSec= 使用;否则需要由监控系统、负载均衡健康检查或受控定时任务识别业务层故障。健康检查应设置连续失败阈值,避免一次网络抖动就重启服务。
配置、权限或数据错误
配置文件语法错误、证书不可读、数据文件损坏等问题不会因为重复执行 ExecStart 自动消失。过于激进的重启策略反而可能掩盖首个错误日志,使排查更困难。
多层守护机制相互冲突
如果应用自身带有守护进程,又同时由 systemd、容器运行时或其他进程管理器重启,可能出现重复拉起、端口冲突和状态判断不一致。一个进程应尽量只确定一个主要生命周期管理者。
依赖单元恢复,不代表应用会自动重连
数据库或网络单元恢复后,已失败的应用是否重新启动,取决于应用自身 Restart=、单元关系以及是否存在明确的动作传播配置。单纯添加 After= 不会让应用在依赖恢复时自动重启。
从业务恢复目标反推systemd参数
配置openEuler服务器的自动恢复机制时,可以按以下顺序确定参数,而不是先选择一个看似积极的 Restart=always:
- 明确什么算故障:是主进程退出、watchdog超时,还是接口不可访问。
- 区分可自动恢复与必须人工处理的退出码,选择
on-failure、on-abnormal或更细的退出状态规则。 - 根据依赖恢复时间和后端承载能力设置
RestartSec=,避免快速重启风暴。 - 使用
StartLimitIntervalSec=与StartLimitBurst=设置熔断边界。 - 只用依赖项表达真实的启动关系,不把
After=当成业务健康检查。 - 将应用启动时间、端口监听和接口就绪时间纳入整体恢复时间,而不是只观察进程PID。
验证异常重启前,应优先在测试环境进行。确认服务允许短暂中断后,可以在一个终端持续观察日志:
journalctl -fu myapp.service
再在另一个终端记录主进程并模拟异常终止。以下操作会立即中断指定服务,只能用于已确认名称和影响范围的非生产测试,或经过批准的维护窗口:
systemctl show myapp.service -p MainPID -p NRestarts

sudo systemctl kill \
  --kill-who=main \
  --signal=SIGKILL \
  myapp.service
随后检查:
systemctl status myapp.service --no-pager -l

systemctl show myapp.service \
  -p ActiveState \
  -p SubState \
  -p Result \
  -p MainPID \
  -p NRestarts
验证不能停留在“出现了新PID”。还应确认端口已经监听、业务接口返回正确、数据库连接恢复、错误日志不再增长,并持续观察是否再次触发重启。只有进程状态与业务状态都恢复,才能说明 systemd配置真正达到了预期的自动恢复目标。