韩国云服务器间歇断连复盘:按时间线定位根因并验证修复结果
本文复盘韩国云服务器新建HTTPS连接间歇失败的问题,按时间线拆分DNS、TCP、TLS与应用层排查,定位nf_conntrack容量耗尽及短连接诱因,并说明容量调整、流量治理和修复验证方法,适合服务器运维人员参考。
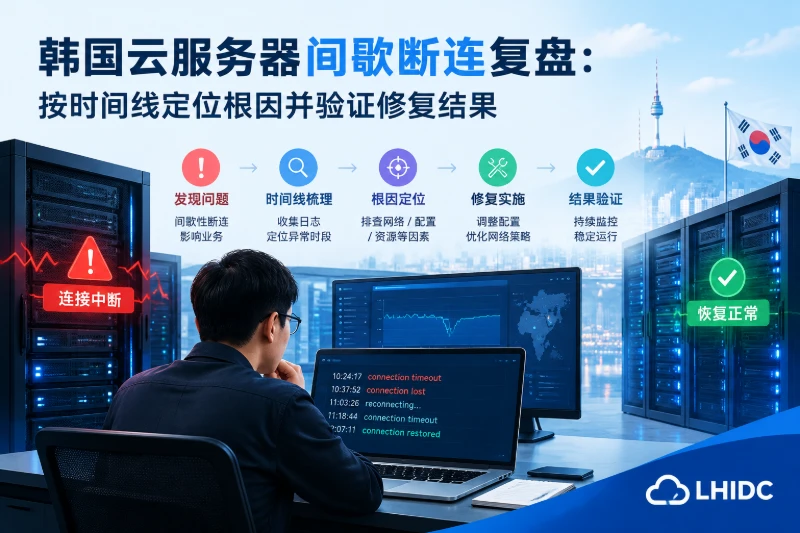
韩国云服务器出现“有时能访问、有时突然超时”时,最容易被直接归因于跨境线路波动。但线路问题、DNS异常、应用阻塞和主机内核丢包都可能呈现相似现象,仅凭一次 Ping 丢包或用户截图无法定性。
本次复盘中的关键特征是:服务器控制台始终可登录,Nginx 进程和监听端口正常,已有连接多数可以继续传输,但新建 HTTPS 连接间歇失败。排查按“统一时间基准、外部复现、确认故障层级、检查应用、检查内核、回溯流量来源”的顺序推进,最终确认直接根因是 Linux 连接跟踪表 nf_conntrack 接近并触及容量上限,新连接无法建立;诱因则是短连接数量集中增长,而不是韩国云服务器整体离线。
先区分“断连”发生在哪一层
用户所说的“断连”可能对应完全不同的问题:
- 域名无法解析:客户端拿不到服务器地址。
- TCP 连接失败:请求尚未进入 TLS 和应用层。
- TLS 握手失败:TCP 已建立,但证书协商或加密握手异常。
- HTTP 请求超时:连接和 TLS 正常,应用没有及时响应。
- 已连接会话中断:可能涉及路由变化、进程重启、负载均衡超时或内核主动丢包。
本次故障中,失败请求的 HTTP 状态码表现为 000,说明客户端没有收到有效的 HTTP 响应。与此同时,部分已建立连接仍能使用。这种“旧连接相对正常、新连接更容易失败”的反常现象,应优先检查 TCP 建连过程、连接队列、状态跟踪表和防火墙,而不是先重启 Nginx。
以下命令以使用 systemd 和 Nginx 的 Ubuntu 22.04/24.04 为例。执行前应先核对实际系统,其他发行版的日志路径、软件包和服务名可能不同:
cat /etc/os-release
uname -r
systemctl status nginx --no-pager
用相对时间还原故障过程
复盘时没有直接使用用户描述的钟点,因为客户端、服务器和监控平台可能采用不同的时区。韩国当地时间为 UTC+9,而服务器日志也可能使用 UTC。应先统一时间基准,再关联访问日志、内核日志和外部探测记录。
date -Is
timedatectl status
如果系统使用 Chrony,还可以检查时间同步状态:
chronyc tracking
本次故障按相对时间整理后,关键节点如下:
| 时间节点 | 观察到的现象 | 当时的判断 |
|---|---|---|
| T+0 | 用户反馈 HTTPS 偶发超时,刷新后可能恢复 | 不能直接判定线路故障 |
| T+10 | 服务器控制台可登录,CPU、内存未出现持续性耗尽 | 排除整机宕机,继续定位网络层级 |
| T+20 | 多个外部来源复现新连接失败,域名解析正常 | 故障集中在 DNS 之后 |
| T+30 | Nginx 进程、80/443 监听正常,失败时段访问日志没有对应请求 | 部分请求可能未到达应用层 |
| T+40 | 内核日志出现连接跟踪表容量不足相关记录 | 转向检查 nf_conntrack |
| T+50 | nf_conntrack_count 反复接近 nf_conntrack_max,丢弃计数在故障窗口增长 |
确认新连接在主机网络栈被丢弃 |
| T+60 | 访问日志显示短时间内集中出现大量短连接请求 | 找到容量耗尽的触发因素 |
| 处置后 | 新建连接恢复,内核丢弃计数不再增长 | 修复方向得到验证 |
时间线的价值不在于“记录做过什么”,而在于证明不同证据是否在同一个故障窗口内出现。只有连接失败、表项接近上限和内核丢弃计数增长同时发生,才能建立较强的因果关系。
按优先级检查,避免一开始就修改配置
1. 从外部拆分 DNS、TCP、TLS 和 HTTP
应从韩国云服务器之外执行检查,最好包含原来发生故障的访问网络。直接在服务器本机执行 curl,无法覆盖公网入口和回程路径。
下面的低频循环用于记录连接耗时与状态码。请将域名和健康检查路径替换为实际地址,并避免对生产接口进行高频压测:
URL='https://example.com/healthz'

for i in $(seq 1 20); do
  date -Is
  curl -sS -o /dev/null \
    --connect-timeout 5 \
    --max-time 10 \
    -w 'remote_ip=%{remote_ip} code=%{http_code} connect=%{time_connect} tls=%{time_appconnect} total=%{time_total}\n' \
    "$URL" || true
  sleep 2
done
如果怀疑 DNS,可以使用服务器 IP 强制访问,同时保留正确的 Host 和 TLS SNI:
curl -v \
  --resolve example.com:443:SERVER_IP \
  --connect-timeout 5 \
  --max-time 10 \
  https://example.com/healthz
判断方式如下:
- 正常解析失败、
--resolve后成功:优先检查 DNS。 - 两种方式都在 TCP 建连阶段失败:继续检查公网路径、访问控制和主机网络栈。
- TCP 成功但 TLS 失败:检查证书、SNI、TLS 配置和中间代理。
- TLS 成功但 HTTP 响应缓慢:转向 Nginx、上游应用和数据库。
MTR 可以辅助观察路径变化,但中间节点不响应或限制 ICMP,并不等于该节点正在丢弃业务流量。不能仅凭某一跳显示高丢包就认定韩国云服务器线路异常。
2. 确认服务是否仍在监听
先做只读检查,不要把“重启服务”当作默认排障动作:
sudo ss -lntp '( sport = :80 or sport = :443 )'
sudo systemctl status nginx --no-pager
sudo journalctl -u nginx --since "30 min ago" --no-pager
还应确认 Nginx 实际使用的日志路径和监听配置:
sudo nginx -T 2>/dev/null | grep -nE 'listen|access_log|error_log'
nginx -T 会输出完整配置,可能包含内部地址或认证信息,不应直接复制到公开工单或聊天窗口。
如果失败时段没有对应访问日志,而监听端口和进程都正常,说明请求可能在进入 Nginx 之前已经被丢弃。但这还不能区分公网路径、云侧访问控制和主机内核,需要继续向下检查。
3. 检查内核连接跟踪状态
nf_conntrack 用于记录经过 Netfilter 的连接状态。启用了防火墙、NAT、容器网络或其他状态检查功能时,新连接通常需要创建对应表项。表满后,内核可能无法跟踪新的 TCP 会话,表现为新连接间歇超时,而已有连接暂时不受明显影响。
先检查相关路径是否存在:
ls -l /proc/sys/net/netfilter/nf_conntrack_count
ls -l /proc/sys/net/netfilter/nf_conntrack_max
如果文件不存在,说明当前环境可能没有加载或使用该机制,本案例的根因判断便不适用,不应继续照搬相关调整。
文件存在时,可以同时读取当前数量与容量上限:
COUNT=$(cat /proc/sys/net/netfilter/nf_conntrack_count)
MAX=$(cat /proc/sys/net/netfilter/nf_conntrack_max)

awk -v count="$COUNT" -v max="$MAX" \
  'BEGIN {printf "count=%d max=%d utilization=%.2f%%\n", count, max, count/max*100}'
单次利用率不能直接证明故障。更有效的方法是在故障窗口连续采样,观察表项是否频繁触及上限:
for i in $(seq 1 30); do
  printf '%s count=' "$(date -Is)"
  cat /proc/sys/net/netfilter/nf_conntrack_count
  printf ' max='
  cat /proc/sys/net/netfilter/nf_conntrack_max
  sleep 2
done
同时检查内核日志:
sudo journalctl -k --since "30 min ago" --no-pager \
  | grep -Ei 'nf_conntrack|table full|drop'
如果已经安装 conntrack 工具,还可以查看统计计数:
sudo conntrack -S
不同内核和工具版本显示的字段可能不同,应重点关注 insert_failed、drop、early_drop 等计数是否在故障期间持续增加,而不是机械比较某个固定阈值。
4. 回溯表项为什么会增长
连接跟踪表满是直接原因,但还需要继续查明触发因素。本次复盘中,访问日志显示某批自动请求没有复用 HTTP 连接,而是在短时间内不断建立新的 TLS 会话。连接关闭后,相关状态也不会瞬间消失,因此表项逐步堆积。
可以先对近期日志做有界分析,避免直接扫描整个大文件:
sudo tail -n 20000 /var/log/nginx/access.log \
  | awk '{print $1}' \
  | sort \
  | uniq -c \
  | sort -nr \
  | head -20
检查请求来源和 URI 时,可以使用:
sudo tail -n 20000 /var/log/nginx/access.log \
  | awk '{print $1, $7}' \
  | sort \
  | uniq -c \
  | sort -nr \
  | head -30
以上字段位置只适用于相近的 Nginx常见日志格式。若使用了自定义 log_format,应先查看实际字段定义。
如果 Nginx 前面还有可信代理或负载均衡,日志中的来源地址可能是代理地址。配置真实客户端地址时,必须只信任明确的代理来源,不能无条件接受客户端提交的 X-Forwarded-For,否则统计和访问控制都可能被伪造。
此外,还应检查本机套接字状态:
ss -s
ss -ant state time-wait | wc -l
TIME_WAIT 数量高并不自动等于故障,它只是短连接活跃的线索。只有它与请求模式、连接跟踪增长和丢弃计数相互吻合时,才具有诊断意义。
根因不是单一参数,而是一条完整因果链
本次故障可以拆成三个层次:
- 直接根因:主机的
nf_conntrack表无法继续容纳新连接,导致部分新建 TCP 会话在到达 Nginx 前被丢弃。 - 触发因素:自动请求集中产生大量短连接,没有合理复用已有连接。
- 容量因素:当前连接跟踪容量无法覆盖该连接模式下的峰值需求。
该判断成立,需要至少满足以下证据:
- 故障主要影响新连接,而不是整台服务器完全失联。
- Nginx 仍在监听,失败请求未进入应用日志。
- 连接跟踪数量在故障窗口接近上限。
- 内核相关丢弃或插入失败计数同步增长。
- 降低短连接输入或调整容量后,新连接恢复且丢弃计数停止增长。
如果只看到表项利用率较高,却没有失败计数和时间相关性,就不能把它直接定为根因。
修复时同时处理流量模式和系统容量
首先修复可控客户端或自动任务的连接方式,启用 HTTP Keep-Alive 和连接池,避免“一次请求建立一次 TLS 连接”。对于已经确认的异常来源,可以在韩国云服务器之前的访问控制层实施限速或过滤,使流量在进入主机连接跟踪之前被处理。
Nginx 的请求限速可以保护后端应用,但它发生在 TCP 和 TLS 建立之后,不能单独解决前端连接跟踪表耗尽。下面仅是针对特定高成本接口的配置示例,示例速率不能直接作为生产阈值:
http {
    limit_req_zone $binary_remote_addr zone=api_per_ip:10m rate=10r/s;

    server {
        location = /api/example {
            limit_req zone=api_per_ip burst=20 nodelay;
            proxy_pass http://app_backend;
        }
    }
}
修改前应备份配置,并确认限速键代表真实客户端地址。配置完成后先检查语法,再平滑加载:
umask 077
sudo nginx -T > "$HOME/nginx-config-$(date +%Y%m%d%H%M%S).txt" 2>&1

sudo nginx -t
sudo systemctl reload nginx
如果需要提高 nf_conntrack_max,必须先评估可用内存和连接增长趋势。不同内核版本、协议状态及扩展字段对应的表项内存开销不同,不应套用固定的“每 GB 内存设置多少条”公式。
先保存旧值并检查内存:
OLD_MAX=$(sysctl -n net.netfilter.nf_conntrack_max)
printf 'old nf_conntrack_max=%s\n' "$OLD_MAX"

free -h
sudo slabtop -o | grep -i conntrack
完成评估后,可先做临时调整。下面的占位符必须替换为经过容量评估的整数:
NEW_MAX='<评估后的整数>'

sudo sysctl -w "net.netfilter.nf_conntrack_max=${NEW_MAX}"
临时调整应先经过业务高峰观察,再决定是否写入 /etc/sysctl.d/ 持久化。不要同时随意缩短连接跟踪超时时间,因为这可能影响长连接、数据库连接、VPN 或其他依赖状态保持的业务。
也不要在生产服务器上直接执行 conntrack -F 清空连接跟踪表。该操作可能中断现有连接,使故障从“间歇失败”扩大为大面积会话断开。
用反向证据确认修复是否有效
修复不能只以“页面现在能打开”为验收标准。应从原故障网络和至少一个独立外部位置继续执行低频探测,并覆盖此前容易出现故障的业务时段。
验证重点包括:
- DNS、TCP、TLS 和 HTTP 各阶段均可持续完成。
nf_conntrack_count与上限之间保持合理余量,不再周期性触顶。insert_failed、drop等计数在连续两次快照之间不再增长。- 内核日志没有新增连接跟踪表容量不足记录。
- Nginx 访问日志能收到外部探测请求。
- 应用错误率、响应时间和已有长连接没有因限速或参数调整而恶化。
必要时可以进行短时间、严格过滤的抓包。抓包可能涉及客户端地址等敏感信息,也会带来一定性能开销,应限制接口、端口和执行时间,不要长期运行:
sudo timeout 60 tcpdump -ni any -s 96 \
  'tcp port 443 and (tcp[tcpflags] & (tcp-syn|tcp-rst) != 0)'
不同结果对应不同方向:
| 抓包与日志结果 | 更可能的问题方向 |
|---|---|
| 客户端失败时,服务器没有收到 SYN | 公网路径、上游访问控制或目标地址错误 |
| 收到 SYN,但服务器没有发出 SYN-ACK,同时连接跟踪丢弃增长 | 主机内核或状态表问题 |
| 服务器发出 SYN-ACK,但客户端没有收到 | 回程路径或中间网络设备问题 |
| TCP 与 TLS 均完成,但 HTTP 长时间无响应 | Nginx、上游应用、数据库或依赖服务 |
| 连接跟踪数量较低且无丢弃增长 | 本次根因不成立,应重新检查其他层级 |
后续监控不宜只设置一个连接跟踪利用率告警。更有效的组合是同时观察当前表项、上限、增长速度、插入失败增量和内核日志,并将它们与新建连接成功率关联。只有在相同故障条件下不再出现原有失败模式,且系统容量、业务请求与应用状态均保持正常,才能认为这次韩国云服务器间歇断连已经完成闭环验证。