业务突发高负载时,如何结合加拿大服务器资源指标、连接数与进程状态定位
本文介绍业务流量突增时,如何在同一时间轴分析加拿大服务器的CPU、内存、磁盘I/O、连接数与进程状态,定位资源队列和阻塞点,并通过现场采样、容量换算及修复验证判断瓶颈原因与扩容时机。
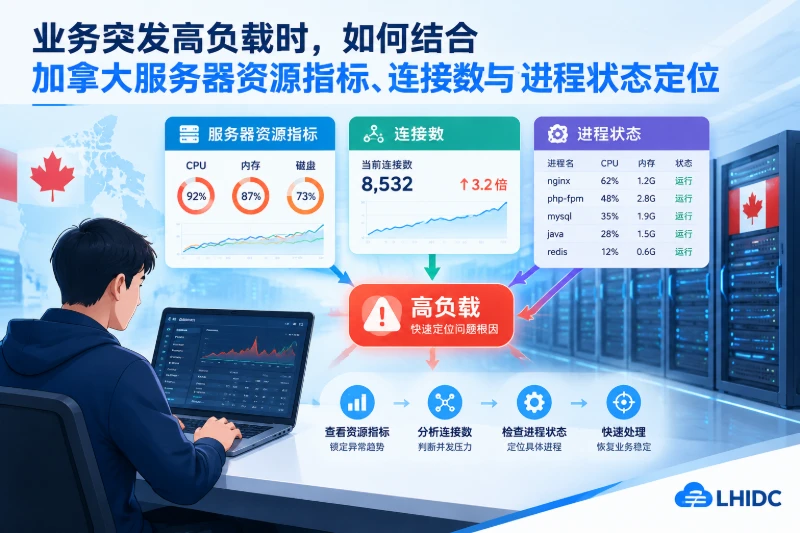
业务流量突然上升时,请求速率、响应时间、并发连接和后台任务会同时变化。加拿大服务器出现负载升高,不能只看 top 中的 CPU,也不能仅凭 Load Average 判断是否需要扩容。更有效的方法是:在同一时间窗口采集 CPU、内存、磁盘 I/O、连接数和进程状态,先找出增长最快的“队列”,再把队列对应到具体进程和请求类型。
判断顺序可以概括为:CPU 运行队列持续增长,优先检查计算瓶颈;内存回收和交换频繁,检查工作集与内存泄漏;I/O 等待伴随设备延迟上升,检查读写进程;连接数增长但请求完成率没有同步提高,检查应用处理速度、连接池与外部依赖;大量进程进入 D、Z 等异常状态,则继续追踪阻塞点或父进程行为。
先确认“高负载”具体指什么
Linux 的 Load Average 表示处于可运行状态和不可中断等待状态的任务数量,不等同于 CPU 使用率。一个服务器 Load Average 很高,可能是 CPU 忙,也可能是大量进程在等待磁盘、网络文件系统或块设备。
排查前应记录以下信息:
- 异常开始时间、持续时长和服务器时区。
- 当时的请求速率、任务量、在线人数或数据处理量。
- 是否发生发布、备份、日志切割、批量导入等操作。
- 问题影响全部业务,还是只影响某个端口、域名或接口。
- 负载是瞬时尖峰,还是持续多个采样周期。
- 虚拟化环境中是否同时出现 CPU steal、存储延迟或宿主资源竞争。
加拿大服务器与访问端可能不在同一时区,应用日志、监控平台和用户反馈时间应先统一。否则,看似同一时刻的 CPU 峰值和错误日志,实际可能相差数小时。
在重启服务之前保留现场
下面的命令适用于使用 systemd、procps 和 iproute2 的现代 Linux 环境,例如较新的 Ubuntu、Debian、Rocky Linux、AlmaLinux。mpstat、iostat 和 pidstat 来自 sysstat 软件包,如系统未安装,应先根据发行版核对包管理器,并尽量在维护窗口安装。
先执行一组低风险采样命令:
date -Is
uptime
nproc
free -h
vmstat 1 10
ss -s

ps -eo pid,ppid,user,stat,psr,pcpu,pmem,rss,etime,comm \
  --sort=-pcpu | head -n 25

ps -eo pid,ppid,user,stat,psr,pcpu,pmem,rss,etime,comm \
  --sort=-rss | head -n 25
如果已经安装 sysstat,继续观察各 CPU、设备和进程变化:
mpstat -P ALL 1 10
iostat -xz 1 10
pidstat -dur 1 10
支持 Pressure Stall Information 的 Linux 内核还可以查看资源压力:
for resource in cpu memory io; do
  if [ -r "/proc/pressure/$resource" ]; then
    echo "== $resource =="
    cat "/proc/pressure/$resource"
  fi
done
这些命令不会修改系统配置。不要在尚未留存信息时立即重启应用、清理缓存或终止进程,否则连接状态、阻塞进程和瞬时 I/O 现场会消失。
把资源指标与进程状态对应起来
排查的重点不是寻找一个“看起来很高”的数值,而是判断哪类任务正在排队。
| 观察组合 | 更可能的瓶颈 | 下一步验证 |
|---|---|---|
CPU us 高,运行队列持续增加 |
应用计算、压缩、加密或代码循环 | 找高 CPU 进程和线程 |
CPU sy 高,连接数或包处理量同步上升 |
系统调用、网络处理、频繁上下文切换 | 查看连接状态、软中断和进程调用特征 |
Load 高、CPU 空闲仍较多、wa 或 D 状态明显 |
磁盘或其他不可中断 I/O 等待 | 查看 iostat、pidstat -d 和内核日志 |
available 持续下降,si/so 非零 |
工作集超过可用内存 | 检查 RSS、交换和 OOM 记录 |
ESTAB 持续增长,吞吐没有同步增长 |
请求处理变慢或上游依赖阻塞 | 按端口和进程统计连接 |
SYN-RECV 增长,监听队列堆积 |
新连接来不及建立或接收 | 检查监听队列、应用接收能力和入口流量 |
CLOSE-WAIT 长时间积累 |
应用未正确关闭被动断开的连接 | 定位持有连接的进程和代码路径 |
| 僵尸进程持续增加 | 父进程没有回收子进程 | 找出 PPID 并检查父进程日志 |
CPU:区分计算繁忙和等待繁忙
mpstat 中常见字段需要结合判断:
%usr或%user高:应用代码消耗 CPU。%sys高:内核调用、网络处理或设备操作较多。%iowait高:CPU 在采样时处于空闲,但系统存在未完成 I/O;它不是磁盘瓶颈的单独证据。%steal高:虚拟机等待宿主分配 CPU 时间,需要结合虚拟化平台进一步确认。vmstat的r持续高于可用 CPU 并不断增长:可运行任务正在排队。
找到高 CPU 进程后,可以检查其线程:
PID=1234
top -H -p "$PID"
请把 1234 替换为实际 PID。若只有一个线程持续占满单核,单纯增加该进程的线程数未必有效;如果多个工作线程同时繁忙,则需要结合请求速率、任务类型和锁竞争继续分析。生产环境使用性能剖析工具前,应先确认其开销和应用兼容性。
内存:重点看可用量、回收和交换
Linux 会把空闲内存用于页缓存,因此 free 很低不代表内存不足。更值得关注的是:
free -h中的available是否持续下降。vmstat的si、so是否反复出现。- 进程 RSS 是否持续增长且不能随业务回落。
- 内核是否记录 OOM Kill。
- PSI 的 memory
some或full压力是否持续增加。
可检查近期内核记录:
journalctl -k --since "-30 min" \
  | grep -Ei 'oom|out of memory|killed process|memory'
如果某个进程 RSS 很大,需要区分正常缓存、固定工作集和泄漏。不要把 drop_caches 当作默认修复手段,它通常只能暂时改变缓存状态,还可能造成后续读 I/O 激增。
磁盘 I/O:同时看延迟、队列和进程
iostat -xz 中可以重点观察:
r/s、w/s:每秒读写请求数量。rkB/s、wkB/s:读写吞吐。await:请求平均完成时间。aqu-sz:设备平均队列长度。%util:设备忙碌程度。
这些指标必须结合存储类型理解。并行存储、虚拟磁盘和云环境中,%util 接近上限不一定等于性能已经耗尽;更可靠的判断是设备延迟、队列长度、应用响应时间是否同步恶化。
用 pidstat 可以查找主要读写进程:
pidstat -d 1 10
如果高 I/O 来自数据库、日志服务或备份进程,应继续检查对应组件日志。常见原因包括慢查询、临时文件增长、日志突发写入、批处理与在线请求争用,以及底层设备延迟。
连接数:判断流量上升还是处理速度下降
连接数量可以用近似关系理解:
并发连接数 C ≈ 请求或连接到达速率 λ × 平均占用时间 T
即使每秒新请求没有明显增长,只要应用响应变慢、上游接口超时或客户端保持连接时间变长,ESTAB 数量也会增加。加拿大服务器面向远距离客户端时,网络往返时间可能增加连接占用时间,因此连接增长不能直接等同于流量增长。
查看 TCP 状态分布:
ss -s

ss -Htan \
  | awk '{count[$1]++} END {for (state in count) print state, count[state]}' \
  | sort

ss -lnt
针对具体业务端口,例如 443:
ss -Htan '( sport = :443 )' \
  | awk '{count[$1]++} END {for (state in count) print state, count[state]}'
常见状态的含义如下:
ESTAB:已建立连接。持续增长时,要看请求完成率和响应时间。SYN-RECV:服务器收到连接请求但握手尚未完成。可能与突发连接、监听处理能力或异常入口流量有关。TIME-WAIT:主动关闭连接后的正常状态。数量较多不一定是故障,需要结合连接创建速率判断。CLOSE-WAIT:对端已经关闭,但本地应用尚未关闭套接字。长期积累通常需要检查应用代码或连接管理。
ss -lnt 中监听套接字的 Recv-Q 持续堆积,说明连接等待应用接收。此时仅调整内核 backlog 可能只是延后故障,还应检查应用工作线程、事件循环和下游依赖。
查看连接对应进程通常需要更高权限:
sudo ss -Htanp
输出可能包含进程信息,应按服务器权限规范保存,不要直接发布到公开工单。
进程状态:定位“忙”还是“卡住”
ps 的 STAT 字段可以快速区分进程状态:
R:正在运行或等待 CPU。S:可中断睡眠,服务进程大部分时间处于该状态并不异常。D:不可中断等待,常见于块设备、网络存储或内核 I/O。Z:僵尸进程,已经退出但父进程尚未回收。T:进程被暂停或跟踪。
筛选异常状态:
ps -eo pid,ppid,user,stat,wchan:32,etime,comm \
  | awk '$4 ~ /^D|^Z|^T/ {print}'
如果大量任务处于 D 状态,应结合 wchan、iostat 和内核日志判断等待位置;如果僵尸进程持续增加,应检查其 PPID 对应的父进程。直接终止僵尸进程通常无效,因为它已经结束,真正需要处理的是父进程未执行回收。
用同一时间轴判断瓶颈链路
高负载经常不是单一资源问题,而是一条连续链路。例如:
- 数据库查询变慢,磁盘
await和队列上升。 - 应用工作线程等待数据库,进程以睡眠或
D状态增多。 - HTTP 请求完成时间拉长,
ESTAB和应用队列增加。 - 新请求继续进入,内存中的请求对象和连接状态增长。
- 超时与重试进一步增加 CPU、连接数和日志写入量。
因此,不能看到连接数高就立即提高连接上限,也不能看到 CPU 高就直接增加工作进程。应先把服务器指标与反向代理访问日志、应用错误日志、数据库慢日志放到同一时间轴上,确认哪个指标最先异常。
如果负载先升高而请求量未变,优先检查单次请求成本和外部依赖;如果请求量先上升,各资源按比例增加,则更接近容量不足;如果只有某个进程或定时任务突增,则属于局部工作负载问题。
把现场数据换算成容量余量
没有实际业务数据时,不应给出固定的“安全并发数”或 CPU 阈值。容量应从当前峰值反推。
CPU 容量
先计算当前繁忙核心数:
繁忙核心数 = 逻辑 CPU 数 × CPU 忙碌比例
在请求类型基本不变、CPU 消耗近似线性的条件下:
单位请求 CPU 需求 = 繁忙核心数 ÷ 当前每秒请求数
预计所需核心数 = 单位请求 CPU 需求 × 预计峰值请求数 ÷ 目标利用率
如果业务包含报表、压缩、图片处理等不同请求类型,应分别计算,不能用平均 QPS 直接外推。
内存容量
内存需求可以拆为:
固定内存 + 工作进程内存 + 活跃连接内存 + 缓存 + 峰值任务临时内存
需要关注峰值工作集,而不是某一刻的空闲内存。若 RSS 随请求增长后能够回落,可能是正常工作集;若业务回落后仍持续增长,则需要排查缓存边界或泄漏。
I/O 容量
磁盘需要同时评估 IOPS、吞吐和延迟。小块随机读写可能先耗尽 IOPS,大文件传输可能先达到吞吐瓶颈,而数据库业务通常对延迟更敏感。容量判断应基于实际读写模型,而不是只看磁盘空间。
连接容量
连接上限受多个环节共同限制:
- 应用工作线程或事件循环处理能力。
- 进程文件描述符限制。
- 监听队列和应用内部等待队列。
- 反向代理、应用与数据库连接池。
- 外连请求使用的本地端口和超时设置。
- 单个连接的内存占用与平均保持时间。
如果连接数上升的根因是响应变慢,扩大连接上限只会让更多请求进入等待,可能进一步消耗内存。
根据瓶颈类型选择处理动作
确认瓶颈后再处理,避免同时改动多个变量:
- CPU 饱和:定位高消耗接口、线程或后台任务;评估缓存、算法优化、任务错峰和横向分担。增加工作进程前先确认仍有 CPU 余量。
- 内存不足:区分正常工作集和泄漏;限制异常任务并检查 OOM。服务重启只能作为临时恢复手段,执行前应评估连接中断和数据一致性。
- I/O 阻塞:查明主要读写进程、文件系统和设备;检查慢查询、日志量、临时文件及批任务。不要只凭
%util修改存储方案。 - 连接堆积:分别处理
SYN-RECV、ESTAB、TIME-WAIT和CLOSE-WAIT;检查应用接收能力、超时、连接池和上游依赖。 - 异常进程状态:对
D状态追踪等待资源,对Z状态检查父进程。不要在不清楚数据写入状态时强制结束进程。
涉及 sysctl、服务重启、进程终止或应用配置修改时,应先备份原配置并记录变更项。回滚方式至少要包括恢复配置、重新加载服务以及验证监听端口和业务健康状态。
修复后如何验证并确定扩容触发点
修复后不能只确认“服务器没宕机”,还应在相同或相近的请求结构下验证:
- CPU 运行队列是否停止增长,各核心负载是否趋于合理。
available是否稳定,交换活动和内存压力是否下降。- 磁盘
await、队列和应用 I/O 等待是否恢复。 ESTAB、SYN-RECV、CLOSE-WAIT是否随业务回落。- 异常
D、Z进程是否不再增加。 - 请求完成率、响应时间和错误率是否恢复。
- 应用、代理和数据库日志是否仍有超时或重试。
扩容触发点不宜直接套用一个固定百分比。更稳妥的方法是收集多个完整业务周期的峰值,找到资源利用率、队列长度与业务响应时间开始同步恶化的转折点,再预留故障切换、流量增长和发布波动所需余量。
当预测峰值在扩容交付周期内将接近该转折点,或者 CPU、内存、I/O、连接队列中的任一项持续侵蚀服务目标,即应启动扩容或架构优化。这样得到的加拿大服务器容量计划,依据的是业务负载和资源关系,而不是单次告警或某个孤立指标。