Portainer控制台响应延迟,如何区分网络丢包与服务器负载问题
本文从客户端与DNS、路由丢包、TCP/TLS连接、服务器资源及应用下游端点分层定位Portainer响应延迟,并结合curl、MTR、TCP重传和负载指标说明判断依据、排查顺序及修复验证方法,适合运维人员处理控制台卡顿与超时问题。
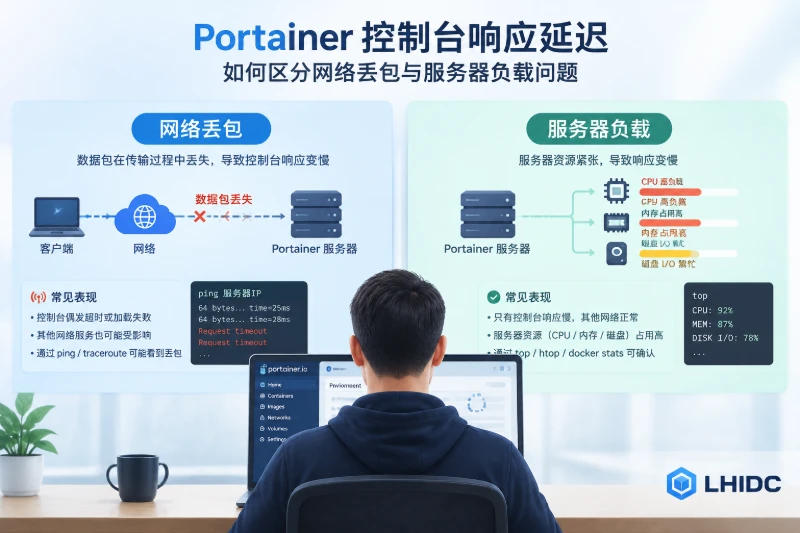
Portainer控制台出现登录超时、页面卡顿或容器列表长时间加载时,生产环境中的首要目标不是立即重启容器或扩大资源,而是确认延迟发生在哪一层。浏览器请求通常会经过本地网络、DNS、路由、反向代理、Portainer服务,以及 Docker API 或 Agent;其中任何一段异常,都可能表现为“控制台很慢”。
建议按“客户端与 DNS → 路由和丢包 → TCP/TLS 连接 → 服务器资源 → 应用及下游端点”的优先级排查。多个独立测试节点同时出现目标地址丢包、连接耗时波动或 TCP 重传增加,更偏向网络问题;连接阶段稳定,但首字节时间升高,并与 CPU 运行队列、磁盘等待或 Swap 活动同步,则更偏向服务器负载。一次 ping 或一个瞬时负载值不足以完成判断,两类问题也可能同时存在。
先锁定故障范围并保留基线
开始检查前,先记录故障时间和时区,并确认以下范围:
- 所有用户都慢,还是只有某台电脑、某个办公室或某条接入网络慢。
- 登录页面、静态资源和所有 Environment 都慢,还是只有某个
/api/请求或远程 Environment 慢。 - 访问是否经过 Nginx、Traefik 等反向代理。
- 管理目标是本机 Docker,还是远程 Docker、Agent 或 Edge Agent。
- 故障时间内是否存在发布、镜像拉取、备份、日志归档或批量容器操作。
- 浏览器报慢时,服务器本机访问是否也慢。
网络和性能记录必须注明测试节点、接入方式、目标 URL、测试时间、时区、测试方法和样本数量。办公室有线网络、家庭网络和服务器本机的结果只能作为不同观察点,不能在路由和环境不同的情况下直接合并。
可以先用下表确定检查方向:
| 观察结果 | 优先排查方向 | 判断依据 |
|---|---|---|
| 只有一台电脑或一个浏览器慢 | 浏览器、代理插件、终端安全软件、本地网络 | 其他设备和接入方式正常 |
| 同一局域网都慢,独立网络正常 | 本地出口、Wi-Fi、网关或 DNS | 异常受接入网络边界限制 |
| 多个外部节点都慢,本机访问正常 | 公网路径、入口或反向代理 | 应用本地响应未同步变慢 |
| 本机和外部访问都慢 | 服务器资源、服务本身或 Docker API | 已绕过大部分外部链路 |
| 基础页面正常,单个 Environment 慢 | 远程 Agent、Docker API 或远端负载 | 延迟集中在特定下游端点 |
| TCP/TLS 稳定,TTFB 与资源压力同步升高 | 服务器负载或应用处理 | 请求已建立连接,但服务端迟迟未响应 |
如后续可能修改 DNS、反向代理、容器资源限制或部署参数,应先备份 Compose 文件及相关配置,并确认持久化数据卷位置。未确认数据位置前,不要删除或重新创建容器。
以下服务器命令以 Linux 和 Docker Engine 为例,可先核对环境:
cat /etc/os-release
docker version
docker compose version 2>/dev/null || true
Docker Desktop、Podman、Kubernetes、rootless Docker 或非 systemd 系统需要使用对应的容器和日志工具,不应直接套用服务名。
按优先级建立延迟证据链
1. 先排除客户端和 DNS
让受影响用户使用浏览器无痕窗口复测,并暂时停用可能拦截请求的代理插件。打开开发者工具的 Network 面板、禁用缓存后重新加载页面,重点观察:
DNS Lookup高:检查本地 DNS、搜索域和解析链路。Initial connection高:检查 TCP 路由、入口端口和代理。- TLS 建连高:检查 TLS 终止节点、反向代理负载和证书链。
Waiting for server response,即 TTFB 高:检查代理上游、应用处理和服务器资源。- 页面框架正常,但某个
/api/请求慢:检查服务到 Docker API 或远程端点的通信。 - TTFB 正常而内容下载慢:检查链路吞吐、客户端接入和响应体传输。
浏览器的“Copy as cURL”可用于在另一台设备上复现同一请求,但复制内容可能包含 Cookie、JWT 或访问令牌,不能直接上传到聊天群、工单或公共平台。
随后使用 curl 拆分 DNS、TCP、TLS、首字节和总耗时。将示例地址替换为实际 URL:
URL='https://portainer.example.com/'

for i in $(seq 1 10); do
  date '+%F %T %z'
  curl -o /dev/null -sS \
    -w 'code=%{http_code} ip=%{remote_ip} dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total}\n' \
    "$URL"
  sleep 2
done
这些字段是从请求开始计算的时间点,其中 time_appconnect 是 TLS 握手完成的累计时间;判断 TLS 阶段时,应结合它与 time_connect 的差值。结果含义如下:
dns单独波动:更偏向 DNS。connect升高:更偏向 TCP 建连或入口网络。connect正常,但 TLS 完成时间增加:检查代理、TLS 终止和证书链。- 连接阶段稳定,但
ttfb升高:更偏向服务端、代理上游或下游 API。 ttfb正常而total高:继续检查传输吞吐和客户端链路。
使用内部 CA 时,优先通过 --cacert /path/to/ca.pem 指定可信 CA。-k 只能在受控诊断中临时跳过证书验证,不能作为正式修复。
DNS 可使用系统解析接口检查:
getent ahosts portainer.example.com
采用 systemd-resolved 的系统还可以执行:
resolvectl query portainer.example.com
若多次解析返回不同地址,应分别验证每个地址是否对应有效入口。只有其中一个地址持续变慢时,应优先检查该入口或相应路径,而不是直接认定容器本身异常。
2. 检查路由、最终目标丢包和 TCP 重传
ping 只能反映 ICMP 探测。部分路由设备会限制 ICMP 响应,因此中间节点显示丢包,不等于业务流量一定丢包。
客户端为 Linux 且已安装 mtr 时,可执行:
mtr -rwzc 50 portainer.example.com
若通过 HTTPS 443 端口访问,可增加 TCP 探测:
mtr --tcp --port 443 -rwzc 50 portainer.example.com
这里的 50 只是连续观察样本,不是统一故障阈值。分析时应区分:
- 中间一跳丢包,但后续节点和最终目标正常:通常只是该节点限制探测响应。
- 从某一跳开始异常,并持续影响后续节点和最终目标:相应路径更值得检查。
- 多个独立客户端都在最终目标出现异常,并与请求超时同步:网络问题的可能性上升。
- ICMP 正常但 TCP MTR、
curl connect或 TLS 仍波动:不能排除业务端口路径异常。
服务器端可观察 TCP 累计统计的前后差值:
nstat -a | grep -E 'TcpRetransSegs|TcpExtTCPTimeouts'
sleep 10
nstat -a | grep -E 'TcpRetransSegs|TcpExtTCPTimeouts'
如果没有 nstat,不要在未获变更许可时直接安装软件包,可先执行:
ss -s
TCP 重传增加不能单独证明公网丢包。CPU 长时间得不到调度、网络队列拥塞或对端异常也可能引发超时和重传,必须与同一时间窗口内的服务器指标对照。
3. 对照服务器负载和请求时间
先检查整机状态,而不是只看单个容器的瞬时 CPU:
uptime
nproc
free -h
vmstat 1 10
uptime 的 Load Average 需要结合 CPU 逻辑核心数、运行队列和 I/O 等待解释。vmstat 中应重点观察:
r持续高于可用 CPU,并伴随 CPU 繁忙:运行队列存在压力。wa持续升高:进程可能在等待存储 I/O。si、so持续变化:存在 Swap 换入换出,可能引起卡顿。- CPU 看似空闲但 I/O 等待高:不能据此认定服务器负载正常。
如果已经安装 sysstat,还可执行:
mpstat -P ALL 1 10
iostat -xz 1 10
pidstat -dur 1 10
不同存储、虚拟化平台和业务模式不存在通用阈值,应比较故障时段与该服务器自身历史基线,并确认资源异常是否与 TTFB 同步。
检查所有容器资源占用:
docker stats --no-stream
镜像构建、数据库、日志处理或备份容器占用 CPU、内存和磁盘时,也可能拖慢 Docker API,最终表现为控制台响应延迟。
4. 区分代理、应用和下游端点
先确认实际容器名称、镜像、状态和端口:
docker ps --format '{{.Names}}\t{{.Image}}\t{{.Status}}\t{{.Ports}}' | grep -i portainer
确认名称后再设置变量:
PORTAINER_CONTAINER='实际容器名称'

docker inspect \
  --format 'status={{.State.Status}} running={{.State.Running}} restart_count={{.RestartCount}} started={{.State.StartedAt}}' \
  "$PORTAINER_CONTAINER"

docker logs --since 15m --timestamps "$PORTAINER_CONTAINER"
日志中可能包含内部地址、用户名和端点信息,导出前需要脱敏。重点查找与故障时间一致的请求超时、连接拒绝、Docker Socket 或 Agent 访问失败、容器重启及持久化目录错误。
Docker 由 systemd 管理时,可检查:
journalctl -u docker --since "15 minutes ago" --no-pager
其他服务管理方式应先核对实际单元名称。
经过反向代理的部署,可以在服务器本机分别测试代理入口和应用直接监听端口。直接端口只能从本机或现有管理网络访问,不要为了诊断临时开放公网防火墙。
- 代理地址慢、直接端口快:检查代理上游连接、TLS、日志和超时配置。
- 两者都慢,并与资源压力同步:优先处理服务器资源竞争。
- 基础页面快,进入特定 Environment 后变慢:检查对应 Agent、远程 Docker API、路由和远端负载。
- 所有 Environment 都慢,但整机资源正常:检查应用日志、持久化存储和 Docker daemon。
单纯增大代理超时只能减少部分超时报错,不能消除真实延迟,不应作为首选修复。
每次只实施一项可回滚变更
网络侧证据明确时,应保留测试节点、时间、目标地址、MTR、TCP 探测和 curl 时间分解结果。可以通过有线网络、独立出口或经批准的 DNS 解析器复测,但不要仅依据一次 ping 丢包就修改防火墙或重建容器。
服务器负载证据明确时,应先定位实际占用资源的进程或容器,再考虑将备份、镜像构建和批量任务移出高峰。调整资源限制前,应备份 Compose 或部署配置,并评估对同机业务的影响。
若问题仅发生在某个远程 Environment,应优先检查服务端到 Agent 或远程 Docker API 的 DNS、端口、路由,以及远端主机资源。不要直接删除并重新添加 Environment,以免丢失管理关系或掩盖原始错误。
确需重启管理服务时,应安排维护窗口并确认持久化数据卷。重启通常不会主动停止已经运行的业务容器,但控制台管理、自动化调用和正在执行的操作可能中断,因此不能视为无风险操作。
修复验证、观察窗口与回滚触发条件
修复后必须使用与故障期间相同的测试节点、URL、请求类型和采样方法重新验证。观察期至少覆盖一个正常业务窗口;如果问题只在高峰出现,还应覆盖对应高峰,不能仅凭低负载时恢复就结束观察。
验证时同时确认:
- 多次
curl中 DNS、连接、TLS、TTFB 和总耗时不再出现原有异常模式。 - 登录、容器列表、日志查看和 Environment 切换均可正常完成。
- TCP 重传增量不再与请求超时同步上升。
- CPU 运行队列、I/O 等待、Swap 和容器资源占用回到自身历史基线。
- 反向代理、管理服务、Docker daemon 和 Agent 日志没有新增超时、连接失败或重复重启。
如果变更后出现更多 5xx、连接失败、延迟继续升高、无法访问下游端点,或服务器资源压力明显加剧,应立即恢复上一份 DNS、代理或容器配置。回滚后继续保留变更前后的同口径样本,避免把短时负载下降误判为修复成功。