大内存服务器上的应用服务启动失败,怎样结合服务状态与依赖日志定位
本文介绍大内存服务器上应用服务启动失败的系统化排查方法,依次核对systemd状态、启动配置、端口、权限、依赖日志及服务级内存限制,并说明常见结果含义、修复分支与复测步骤,适合Linux运维及故障处理人员参考。
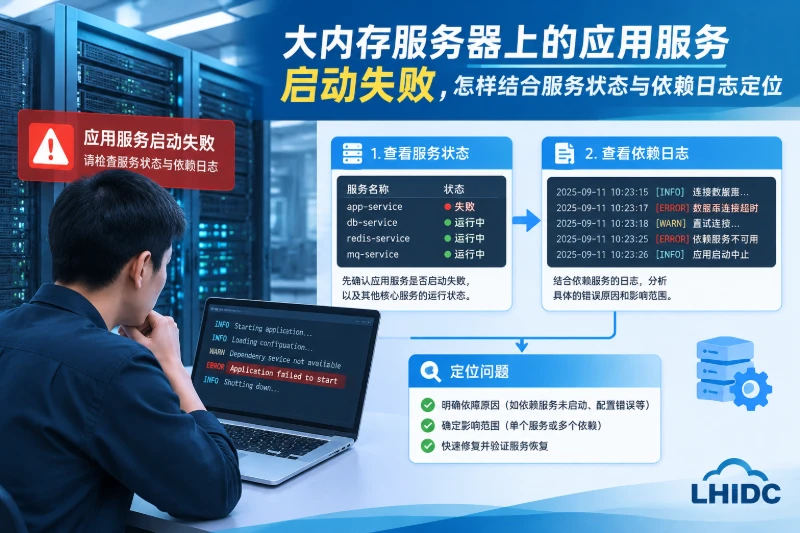
应用服务执行启动命令后立即退出、长时间停留在 activating,或者显示 active 但端口没有监听时,不能仅凭“大内存服务器还有很多内存”排除资源问题。物理内存容量、操作系统可用内存、systemd 服务限制以及容器或 cgroup 配额是不同层级,应用也可能因为端口冲突、运行用户无权限、依赖未就绪或配置错误而启动失败。
排查时应先固定故障时间和服务状态,再依次检查启动命令、端口与目录、运行权限、外部依赖、应用日志,最后核对内存限制和内核事件。这样的顺序风险较低,也能避免看到某条错误后直接改配置,却忽略更早出现的根因。
先确认服务究竟失败在哪个阶段
以下命令适用于使用 systemd 的 Linux 系统,例如常见的 Ubuntu、Debian、Rocky Linux、AlmaLinux 和 RHEL。示例服务名为 app.service,使用时应替换为真实名称。若不确定服务名,可先查询:
systemctl list-units --type=service --all | grep -i app
先查看完整状态,不要只执行 systemctl is-active:
sudo systemctl status app.service --no-pager -l
重点观察以下内容:
Loaded:单元文件是否成功加载,是否指向预期路径。Active:是failed、activating,还是启动后又变成inactive。Process和ExecStart:实际执行了哪个命令。Main PID:主进程是否曾成功创建。status=、code=:进程退出方式和退出码。- 最后几行日志:通常能看到配置、权限或依赖错误的第一条线索。
再提取便于判断的状态字段:
sudo systemctl show app.service \
  -p ActiveState \
  -p SubState \
  -p Result \
  -p ExecMainCode \
  -p ExecMainStatus \
  -p NRestarts
常见结果可以按下表理解,但最终仍要以应用日志为准:
| 状态或现象 | 通常指向 | 下一步 |
|---|---|---|
203/EXEC |
启动文件不存在、不可执行或解释器有问题 | 检查 ExecStart 路径、权限和脚本首行 |
200/CHDIR |
WorkingDirectory 不存在或无法进入 |
检查目录及父目录权限 |
217/USER |
配置的运行用户不存在或无法切换 | 核对 User= 和系统账户 |
216/GROUP |
配置的运行组不存在 | 核对 Group= |
status=1/FAILURE |
应用主动报错退出 | 继续查应用和依赖日志 |
status=137 或 SIGKILL |
进程被强制终止,可能涉及 OOM 或人工操作 | 查内核日志、cgroup 限制和操作记录 |
一直处于 activating |
启动过程阻塞或通知机制不匹配 | 查依赖连接、超时和 Type= 配置 |
显示 active 但无端口 |
端口配置错误、子进程退出或服务本身不监听网络 | 查进程、套接字和应用日志 |
注意记录状态中的失败时间。后续查看应用、数据库和系统日志时,应围绕同一时间窗口进行关联,避免被较早的历史错误干扰。
核对 systemd 实际执行的配置
应用在命令行中可以启动,不代表通过 systemd 也能启动。两者可能使用不同的用户、工作目录、环境变量和资源限制。
查看当前生效的单元内容:
sudo systemctl cat app.service
查看关键运行参数:
sudo systemctl show app.service \
  -p ExecStart \
  -p User \
  -p Group \
  -p WorkingDirectory \
  -p EnvironmentFiles \
  -p FragmentPath \
  -p DropInPaths
检查时应重点回答几个问题:
ExecStart指向的程序是否真实存在,符号链接是否有效。- 脚本是否有执行权限,首行解释器路径是否存在。
WorkingDirectory是否存在,服务用户能否进入。- 配置文件路径使用的是绝对路径还是相对路径。
- 是否存在覆盖主配置的 drop-in 文件。
- 服务依赖的环境变量是否只配置在登录用户的 Shell 文件中。
可使用以下只读命令核对启动文件:
sudo ls -l /opt/myapp/bin/start.sh
sudo file /opt/myapp/bin/start.sh
sudo head -n 1 /opt/myapp/bin/start.sh
sudo namei -l /opt/myapp/bin/start.sh
如果应用支持配置检测功能,应先运行其官方提供的检查命令,再尝试重启。例如 Nginx 可使用 nginx -t,其他应用应查阅对应版本文档,不要猜测不存在的 --check 参数。
修改单元文件前应先备份:
sudo cp -a /etc/systemd/system/app.service \
  /etc/systemd/system/app.service.bak.$(date +%Y%m%d%H%M%S)
修改完成后需要重新加载 systemd 配置:
sudo systemctl daemon-reload
daemon-reload 只重新读取单元文件,不会自动重启业务。若发现修改无效,可将备份文件恢复后再次执行该命令。
从端口和进程判断是否发生冲突
端口被占用时,应用通常已经完成部分初始化,直到绑定监听地址时才退出。日志中可能出现 Address already in use、bind failed 或类似错误。
假设应用应监听 TCP 8080 端口,可执行:
sudo ss -lntp 'sport = :8080'
如果系统中的 ss 不支持端口过滤,也可查看全部监听端口后再筛选:
sudo ss -lntp | grep ':8080'
结果分为三种情况:
- 端口被其他进程占用:先确认该进程是否属于旧实例或另一项业务,不要直接执行
kill -9。应选择修改端口,或通过对应服务管理器有序停止冲突服务。 - 端口没有监听,服务立即退出:继续查看应用日志,通常是配置、权限或依赖问题。
- 端口已经监听,但 systemd 判定失败:可能存在主进程派生方式、PID 文件或
Type=forking配置不匹配。
还应确认应用绑定的地址。如果只监听 127.0.0.1,远程访问会失败,但这不等同于启动失败:
sudo ss -lntp
不要在未确认业务归属前通过修改防火墙掩盖问题。防火墙会影响外部连接,却通常不会导致进程无法绑定本地端口。
检查运行用户、目录与安全策略
应用启动时往往需要读取配置、证书和密钥,并向日志目录、数据目录、临时目录或 PID 文件目录写入内容。任何一个父目录缺少执行权限,都可能导致服务用户无法访问目标文件。
先确定服务用户,然后使用该用户测试,不要只用 root 验证:
sudo -u appuser test -r /etc/myapp/app.yaml
echo $?

sudo -u appuser test -w /var/lib/myapp
echo $?

sudo namei -l /var/lib/myapp
返回值为 0 表示测试通过,非 0 表示权限或路径不满足要求。还可检查磁盘、inode 和只读挂载,因为这些问题经常表现为“无法创建 PID 文件”或“日志初始化失败”:
df -h
df -i
findmnt -no TARGET,OPTIONS /var/lib/myapp
如果确认目录属主配置错误,修改前应保存原有 ACL 和属主信息:
sudo getfacl -p /var/lib/myapp > /root/myapp-acl-backup.txt
只有在已经核对应用文档、安装包默认设置和实际运行用户后,才能进行针对性修正。例如:
sudo chown appuser:appgroup /var/lib/myapp
不要使用 chmod -R 777。它既可能扩大敏感文件的访问范围,也会破坏原有权限设计。需要回滚时,可根据备份恢复:
sudo setfacl --restore=/root/myapp-acl-backup.txt
启用 SELinux 的系统还应检查是否存在访问控制拒绝:
getenforce
sudo ausearch -m AVC -ts recent
Ubuntu 等启用 AppArmor 的环境可查看:
sudo aa-status
sudo journalctl -k --since "30 minutes ago" | grep -i apparmor
发现安全策略拒绝时,应根据应用需要补充正确规则或恢复文件安全上下文,而不是直接关闭 SELinux、AppArmor。
把应用日志与依赖日志放在同一时间线上
systemctl status 只显示有限的近期信息。完整日志应使用 journalctl 查看:
sudo journalctl -u app.service \
  --since "30 minutes ago" \
  --no-pager \
  -o short-iso
如果刚刚执行过一次启动,可查看本次系统启动周期中的日志:
sudo journalctl -u app.service -b --no-pager -o short-iso
日志定位时不要只搜索最后一行。应用最后可能只打印“启动失败”,真正原因往往出现在前面,例如:
- 配置文件解析失败。
- 数据库认证被拒绝。
- 域名无法解析。
- TLS 证书或私钥无法读取。
- 消息队列、缓存或注册中心连接超时。
- 数据目录锁未释放。
- 版本升级后配置项不兼容。
- 初始化脚本执行失败。
先查看 systemd 声明的依赖:
sudo systemctl show app.service -p Requires -p Wants -p After
sudo systemctl list-dependencies app.service
需要注意,After= 只规定启动顺序,不保证目标服务已经可以接受业务请求;外部数据库、远程缓存等依赖也可能根本没有写入 systemd 单元。
假设应用依赖 postgresql.service 和 redis.service,可对齐时间查看:
sudo systemctl status postgresql.service redis.service --no-pager -l

sudo journalctl \
  -u app.service \
  -u postgresql.service \
  -u redis.service \
  --since "30 minutes ago" \
  --no-pager \
  -o short-iso
对于远程依赖,先验证名称解析:
getent ahosts db.example.internal
如果系统已经安装 netcat,可验证 TCP 端口连通性:
nc -vz -w 3 db.example.internal 5432
连接成功只表示 TCP 端口可达,不代表账户、密码、数据库名称、TLS 参数和应用协议一定正确。若依赖日志显示认证失败,应核对密钥来源、环境文件和凭据有效性,而不是反复重启应用。
查看单元文件或环境文件时还要注意敏感信息。复制日志用于协作排查前,应脱敏数据库密码、令牌、证书私钥和连接字符串。
大内存服务器仍要检查服务级内存限制
大内存服务器的物理内存很多,但应用实际可用内存可能受到以下因素限制:
- systemd 单元设置了
MemoryMax=或MemoryHigh=。 - 服务运行在容器或 cgroup 中,存在独立内存上限。
- JVM、数据库等应用设置了过大的预分配值。
LimitAS、LimitMEMLOCK等限制不满足应用要求。- 其他进程已占用大量内存,当前
MemAvailable不足。 - 进程在启动阶段触发 OOM,被内核或 cgroup 终止。
先查看主机内存状态:
free -h
grep -E 'MemTotal|MemAvailable|SwapTotal|SwapFree|HugePages' /proc/meminfo
swapon --show
判断内存余量时优先关注 MemAvailable,不要只看 free 列。Linux 会使用空闲内存作为缓存,这部分通常可以回收。
继续查看服务限制:
sudo systemctl show app.service \
  -p MemoryCurrent \
  -p MemoryHigh \
  -p MemoryMax \
  -p MemorySwapMax \
  -p LimitAS \
  -p LimitDATA \
  -p LimitMEMLOCK \
  -p TasksMax
如果 MemoryMax 显示具体数值而不是无限制,应用能使用的内存上限就是该服务所在 cgroup 的限制,而不是整台大内存服务器的容量。对于 JVM 等应用,还需保证堆内存之外留有本地内存、线程栈、直接内存和共享库空间。将最大堆直接设置为接近服务内存上限,可能在启动或运行初期被终止。
检查内核是否记录 OOM:
sudo journalctl -k \
  --since "2 hours ago" \
  --no-pager | grep -Ei 'out of memory|oom-kill|killed process'
如果日志明确指向 OOM,应先判断是主机整体内存不足,还是服务 cgroup 达到上限。修改 MemoryMax、JVM 堆或数据库缓存前,要备份原配置并评估同机其他业务的内存需求,不能因为服务器总内存较大就无限提高单个服务的额度。
某些数据库或计算应用会使用 HugePages 或锁定内存。只有当应用日志明确出现 HugePages、mlock 或 Cannot allocate memory 等信息时,才需要进一步检查 HugePages_Free 和 LimitMEMLOCK;普通 Web 服务不必一开始就调整这类内核参数。
按错误结果选择处理分支
完成上述检查后,启动失败通常会落入以下分支:
启动命令或配置错误
先使用应用自身的配置校验功能,确认二进制路径、配置语法和版本兼容性。修改前备份配置,修复后重新执行检查命令,再启动服务。
端口被占用
确认占用进程归属。如果是残留旧实例,应通过原服务管理方式停止;如果是其他正常业务,应调整其中一方端口和相关反向代理或服务发现配置。不要直接强制结束未知进程。
权限或安全策略拒绝
确认服务实际运行用户、目录用途和软件要求,再修复单个目录或文件。SELinux、AppArmor 拒绝应按审计日志调整规则,不应通过永久关闭安全机制解决。
依赖服务未就绪
同时检查应用端错误和依赖端日志。连接拒绝通常表示端口未监听;连接超时更可能涉及地址、路由或访问控制;认证失败则应核对账户、权限和凭据。依赖恢复后,再启动应用并观察是否仍有初始化错误。
服务级内存不足
根据 cgroup 限制、应用内存参数和 OOM 日志判断。调整时必须保留系统及其他进程所需空间,并准备恢复原配置。若只有应用日志提示内存分配失败而内核没有 OOM 记录,还应检查应用自身的堆、共享内存、锁定内存或地址空间限制。
修复后进行一次完整复测
确认配置无误后,可先清除 systemd 保存的失败状态,再启动服务:
sudo systemctl reset-failed app.service
sudo systemctl start app.service
对于数据库、消息队列等有状态服务,启动前应确认没有正在执行的数据恢复、迁移或维护任务。不要在不清楚业务状态时连续重启。
启动后依次验证:
sudo systemctl is-active app.service
sudo systemctl status app.service --no-pager -l
sudo systemctl show app.service -p NRestarts -p ExecMainStatus
sudo ss -lntp
如果应用提供健康检查接口,可按实际地址验证,例如:
curl --fail --silent --show-error \
  http://127.0.0.1:8080/health
没有健康检查接口时,应使用应用支持的只读查询或实际业务请求验证,而不是只看进程存在。随后持续观察一段时间的日志和内存变化:
sudo journalctl -u app.service -f
服务状态保持 active、预期端口正常监听、依赖请求成功、NRestarts 不再增加,并且日志中没有新的权限、连接或内存错误,才能认为本次启动故障已经解除。若服务启动后又周期性退出,应保留首次异常时间点及其前后日志,继续从退出信号、依赖波动和服务级资源限制三个方向追踪。