香港服务器内存不足引发NVMe交换频繁,如何定位OOM与进程占用
介绍香港服务器出现内存不足、Swap占用及NVMe读写升高时的排查方法,涵盖可用内存与缓存判断、换页监测、OOM日志分析及进程RSS和PSS定位,适合Linux运维人员参考。
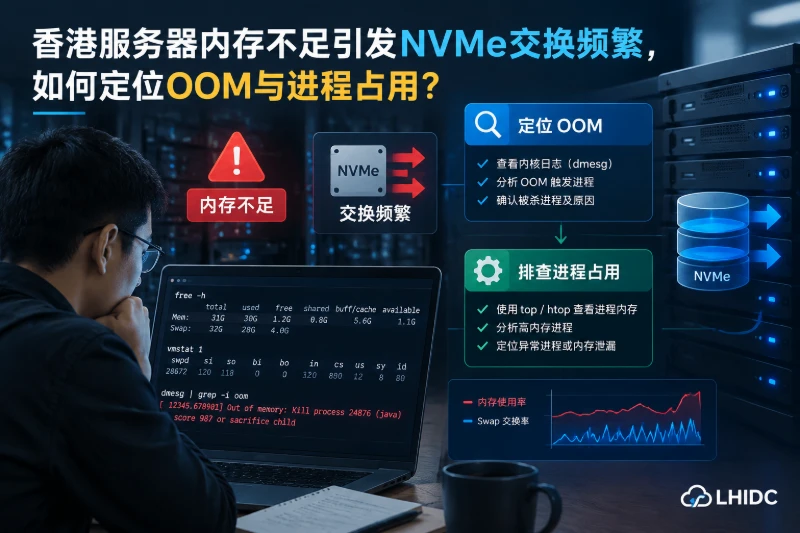
网站响应突然变慢、NVMe SSD硬盘读写持续升高,同时 free 显示 Swap 已被占用,通常需要先区分三种情况:历史交换页尚未释放、当前正在频繁换页,或系统已经触发 OOM。NVMe 能缩短部分交换等待时间,但不能替代物理内存;当业务工作集超过可用内存时,请求延迟、随机磁盘访问和 SSD 写入量仍会增加。
排查香港服务器上的这类问题,应先看 MemAvailable 和 vmstat 的 si/so,再检查 OOM 日志及进程 RSS、PSS。服务器所在地区不会改变 Linux 内存管理机制;“香港服务器,NVME SSD硬盘”描述的是部署位置与存储介质,真正决定故障表现的是物理内存、进程工作集、服务或容器限制,以及交换空间是否位于该 NVMe 设备。
第一步:确认是缓存、历史Swap还是实际内存压力
Linux 会利用闲置内存作为文件缓存,因此 free 很低不一定表示内存不足。先执行只读检查:
free -h
swapon --show
grep -E 'MemTotal|MemFree|MemAvailable|Cached|SwapTotal|SwapFree|Slab|SReclaimable' /proc/meminfo
判断时以以下组合为准:
| 观察结果 | 判断方向 |
|---|---|
MemAvailable 尚有余量,Swap 已占用,但 si/so 接近静止 |
多为历史交换页,不代表当前故障 |
MemAvailable 持续偏低,si/so 连续变化 |
存在实际内存压力和频繁换页 |
| 主机仍有可用内存,单个服务或容器被终止 | 优先检查 cgroup 内存上限 |
日志出现 Out of memory、Killed process 或 Memory cgroup out of memory |
已触发主机级或 cgroup 级 OOM |
Swap 不会在压力解除后立即归零。内存紧张时直接执行 swapoff 可能制造瞬时内存峰值并触发 OOM,不应把清空 Swap 当作常规修复方法。
第二步:在同一时间窗口观察换页和I/O
先核对发行版与内核,再连续采样:
cat /etc/os-release
uname -r
vmstat 1 10
cat /proc/pressure/memory
vmstat 中,si 表示从交换空间读回,so 表示写入交换空间;wa 反映 CPU 等待 I/O 的时间比例。单次出现 si/so 不能证明交换风暴,只有它们在业务变慢时持续活跃,并伴随 wa、磁盘队列或应用延迟上升,才可将问题指向频繁交换。
支持 PSI 的内核可通过 /proc/pressure/memory 查看内存回收造成的停顿。some 表示部分任务受影响,full 表示所有非空闲任务同时受影响,应结合自身正常时段基线观察趋势,不宜机械套用固定阈值。
若已安装 sysstat,同步检查 NVMe:
iostat -xz 1 10
应先通过 swapon --show 确认交换分区或交换文件所在设备。若 si/so 持续活跃,同时对应 NVMe 设备的队列、等待时间和利用率上升,才能判断交换正在争用磁盘资源;如果 si/so 基本为零,应继续检查数据库、日志或文件服务的 I/O。
第三步:定位真实占用内存的进程
先按常驻内存 RSS 排序:
ps -eo pid,user,comm,%mem,rss,vsz --sort=-rss | head -n 20
VSZ 包含未实际驻留的虚拟地址空间,不能直接视为真实内存消耗。RSS 更接近常驻物理内存,但共享页可能被重复计算。分析单个进程时,可查看 PSS 和私有页:
PID=1234
grep -E '^(Rss|Pss|Private_Clean|Private_Dirty|Swap):' /proc/$PID/smaps_rollup
将 1234 替换为实际 PID。若内核不提供 smaps_rollup,可使用:
PID=1234
grep -E 'VmRSS|VmSwap|VmSize|Threads' /proc/$PID/status
部分进程详情需要 root 或相应权限。判断内存泄漏不能依赖单次快照:应在相近业务负载下分时记录 RSS 或 PSS。若请求量已回落,而私有内存仍持续增长,再检查对象缓存、连接释放、线程数量及应用堆配置。
安装了 sysstat 时,还可连续观察缺页和内存变化:
pidstat -r -p ALL 1 5
Debian、Ubuntu 通常通过 apt 安装 sysstat,RHEL 系发行版通常使用 dnf;安装前应核对系统版本和软件源策略。
第四步:确认OOM发生在主机还是服务限制层
systemd 系统可查询内核日志:
journalctl -k --since "-2 hours" | grep -Ei 'out of memory|oom-kill|killed process|memory cgroup'
无法使用 systemd 日志时,可尝试:
dmesg -T | grep -Ei 'out of memory|oom-kill|killed process|memory cgroup'
Killed process 可以定位被终止的 PID 和进程名,但被杀进程不一定是内存泄漏源。OOM 选择还会受到进程占用及 oom_score_adj 等因素影响,必须结合故障前的监控记录判断。
若只有一个 systemd 服务异常,检查其限制:
systemctl show example.service \
  -p MemoryCurrent \
  -p MemoryHigh \
  -p MemoryMax \
  -p OOMPolicy
将 example.service 替换为实际服务名。若 MemoryMax 低于应用峰值,即使整台服务器仍有空闲内存,也可能发生 cgroup OOM。Docker 环境可辅助查看:
docker stats --no-stream
处理顺序与修复验证
发现异常进程后,应先保存日志、进程指标和应用现场,再决定是否重启。直接重启虽然会释放内存,但可能清除泄漏趋势并造成业务中断。处理顺序通常是:
- 降低并发、工作进程数或单任务内存峰值。
- 核对 JVM 堆、数据库缓存、PHP-FPM 子进程等应用级限制。
- 修正容器或 systemd 服务中与实际负载不匹配的内存上限。
- 判断物理内存是否能够容纳长期业务工作集。
- 工作集可控后,再评估交换倾向:
sysctl vm.swappiness
调整 vm.swappiness 前应记录原值、小范围观察并准备恢复。降低该参数不能阻止真正的内存耗尽,也不建议通过清空缓存或强制 swapoff 进行所谓优化。
修复后应覆盖至少一个业务高峰窗口,重新检查:
free -h
vmstat 1 10
cat /proc/pressure/memory
journalctl -k --since "-30 minutes" | grep -Ei 'out of memory|oom-kill|killed process|memory cgroup'
有效修复应表现为 RSS 或 PSS 不再无界增长、MemAvailable 保持合理余量、si/so 不再持续活跃,并且没有新增 OOM 记录。偶发批处理引起的短时换页可通过错峰和并发限制缓解;如果工作集长期超过物理内存,即使交换空间位于 NVMe SSD硬盘,也只能暂时缓冲压力,不能替代减少进程占用、修正服务限制或增加内存容量。