香港GPU服务器适合哪些AI业务:训练、推理与数据规模如何判断
本文从访问路径、显存与并发、训练周期、数据容量、存储及带宽等维度,判断香港GPU服务器是否适合在线推理、中小规模训练微调和批量处理,并说明多卡扩展、跨网络读写、流量成本等不适用边界及下单前测试要点。
先判断负载,而不是先看GPU型号
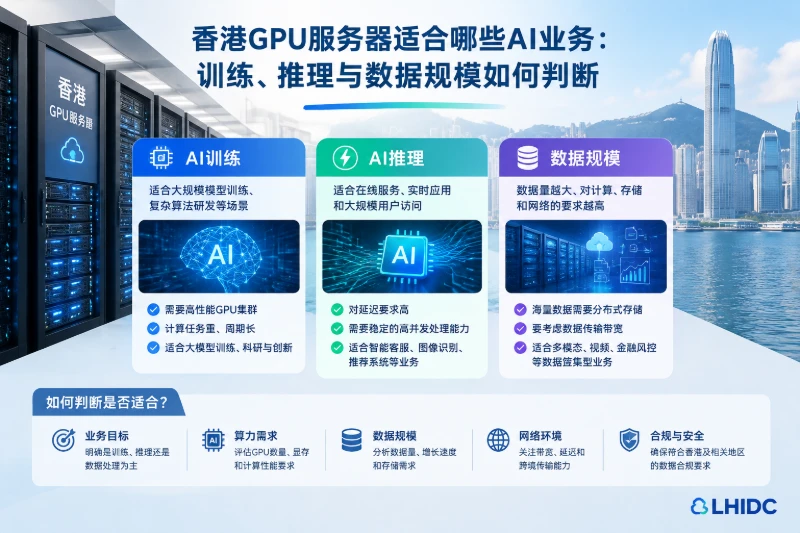
同样是AI业务,实时问答、图片生成、视频分析和大模型训练对服务器的要求完全不同。香港GPU服务器更适合以下场景:用户访问路径主要经过香港、业务需要独立GPU资源、模型和数据能够在单机或有限多卡环境内运行,并且数据传输、存储及带宽成本可控。
如果项目需要长期运行超大规模分布式训练、频繁从异地同步海量数据,或者必须依赖高速GPU集群互联,仅凭“香港节点”和“配有GPU”并不足以支撑业务。选购时应依次量化模型显存、并发量、训练周期、数据容量和网络流量,再判断具体方案。
哪些AI业务更适合
面向香港及周边用户的在线推理
在线聊天、翻译、语音识别、图像生成、内容审核和推荐接口都属于推理业务。服务器位置不会提高GPU本身的计算能力,但会影响用户到服务端的访问路径。因此,当主要用户、业务系统或数据入口位于香港及周边区域时,将推理节点部署在香港通常更便于控制端到端响应时间。
这类业务的主要瓶颈不是模型能否启动,而是峰值并发下能否稳定响应。需要重点观察:
- 模型权重加载后占用多少显存;
- 上下文长度增加时,KV Cache需要多少空间;
- 单次请求的输入、输出规模;
- 峰值并发与排队长度;
- 首个结果返回时间和完整请求耗时;
- GPU利用率较低时,CPU、内存或数据预处理是否已成为瓶颈。
如果推理流量波动明显,还应核算空闲时段的GPU成本。长期租用独立GPU通常更适合持续负载,而不是每天只有少量、不可预测的请求。
中小规模训练与微调
图像分类、目标检测、语音模型训练,以及大模型LoRA、QLoRA等参数高效微调,可以考虑香港GPU服务器,但前提是模型、优化器状态、激活值和训练批次能够装入可用显存。
不能只按模型文件大小估算训练显存。以参数量为基础,模型权重理论占用可按下式初步计算:
模型权重显存 ≈ 参数量 × 每个参数的字节数
但完整训练还会增加梯度、优化器状态、激活值和框架缓存,实际需求可能明显高于权重本身。采购前应使用目标框架、精度和批次进行小规模试跑,而不是依据模型下载文件的容量直接选择GPU。
当单卡显存不足时,可以采用梯度累积、混合精度、检查点重计算或参数高效微调。若必须多卡运行,则还要确认GPU之间的连接方式和通信能力;多卡数量增加并不代表训练速度会线性提升。
批量图像、音视频和数据处理
批量图片识别、视频转码后分析、OCR、Embedding生成等任务通常不强调单次响应时间,更关注单位时间处理量。这类业务可能同时受GPU计算、CPU解码、内存缓存和磁盘读取速度影响。
例如,视频文件很多但GPU利用率一直不高,问题可能出在CPU解码或存储读取,而不是GPU性能不足。配置时应将完整处理链路拆开测量,避免只升级GPU,却没有改善总体吞吐量。
用数据规模判断是否合适
数据规模不能只看“总共有多少GB”,还应看数据如何进入服务器、训练时读取多少次,以及会产生多少中间文件。
本地存储容量至少需要覆盖:
所需容量 = 原始数据 + 清洗或解压数据 + 模型文件
         + 训练检查点 + 推理结果 + 日志 + 预留空间
假设原始数据为300GB,解压和预处理后变为500GB,还要保留多个检查点,那么只按300GB选择磁盘很容易在训练中途耗尽空间。频繁保存检查点时,还应关注持续写入速度和单次保存耗时。
数据首次上传时间可以使用下面的方式估算:
理论传输时间(秒)≈ 数据量(GB)× 8000 ÷ 有效传输速率(Mbps)
例如500GB数据以200Mbps的有效速率持续传输,理论时间约为20000秒,即约5.6小时。实际还会受到协议开销、网络波动和并发限制影响,因此结果只适合做预算估算。
如果每轮训练都要跨网络读取数据,GPU可能长时间等待数据。更合理的方式通常是先将训练集完整落盘,再从本地高速存储读取。若数据无法在计划窗口内同步,或者每天都有大量数据反复传入、传出,香港GPU服务器的网络与流量成本就需要优先评估。
从业务需求反推配置重点
| 业务类型 | 首要指标 | 容易忽略的瓶颈 | 选择重点 |
|---|---|---|---|
| 大模型在线推理 | 显存、并发、上下文长度 | KV Cache、排队、出站流量 | 先用真实请求压测峰值并发 |
| 图像生成 | 显存、单任务耗时 | 模型切换和磁盘加载 | 确认多模型是否需要同时驻留 |
| 模型微调 | 训练显存、单步耗时 | 检查点写入和数据读取 | 用目标精度、批次试跑 |
| 视频分析 | GPU吞吐量 | CPU解码、存储顺序读取 | 同时核对CPU、内存和磁盘 |
| Embedding与RAG | 批处理能力 | 向量库、CPU内存和索引存储 | GPU与检索组件分别评估 |
推理场景应记录每秒请求数、首包时间、完整响应时间、显存峰值和队列长度;训练场景则应记录每秒样本数、单步耗时、显存峰值、数据加载等待和检查点保存时间。只有这些指标符合业务目标,配置才算匹配。
哪些情况下不宜直接选择
以下情况不适合仅按常规单机GPU方案采购:
- 训练任务需要大量GPU协同,但产品未明确多卡拓扑和扩展方式;
- 核心数据长期位于其他位置,每轮任务都要重复跨网络读取;
- 业务主要成本来自大规模出站流量,但带宽计费边界尚未确认;
- 模型显存需求、上下文长度和并发量尚未测算;
- 业务要求随时增加大量GPU,但服务的扩容周期和资源边界不明确;
- 数据有特定存放、访问审计或跨境要求,却尚未完成合规核对;
- 项目处于早期验证阶段,GPU长期闲置时间可能明显高于工作时间。
尤其要注意,香港GPU服务器解决的是部署位置和计算资源问题,不会自动解决模型优化、分布式训练效率、数据合规或应用架构问题。
下单前核对事项
- 使用真实模型确认权重、框架缓存和峰值显存占用。
- 分别测算平均并发与峰值并发,避免只按日请求总量选型。
- 统计原始数据、处理后数据、检查点、日志和预留空间。
- 估算首次上传、每日增量同步及结果下载所需带宽和流量。
- 确认GPU是独占还是共享,并核对显存容量、多卡拓扑及驱动环境。
- 核对CPU核心数、内存、磁盘类型和容量,防止非GPU组件限制吞吐。
- 明确带宽口径、流量计费、扩容周期、备份方式和故障处理边界。
- 在正式迁移前,用真实数据和峰值请求完成短期验证,记录延迟、吞吐、显存、GPU利用率及磁盘等待。
当访问路径、GPU负载和数据规模都能量化时,香港GPU服务器是否适合就不再是地区或单项硬件参数的比较,而是计算效率、网络成本、扩容能力与持续运营成本之间的取舍。