香港GPU服务器在哪些负载条件下可能达不到预期:上线前如何验证显存与网络吞吐
本文梳理模型权重、激活值、KV Cache、数据传输及单连接限制导致性能不及预期的场景,并提供显存峰值、GPU利用率、双向吞吐、延迟与丢包的可复现测试方法,帮助上线人员通过对照复测确定配置适用边界。
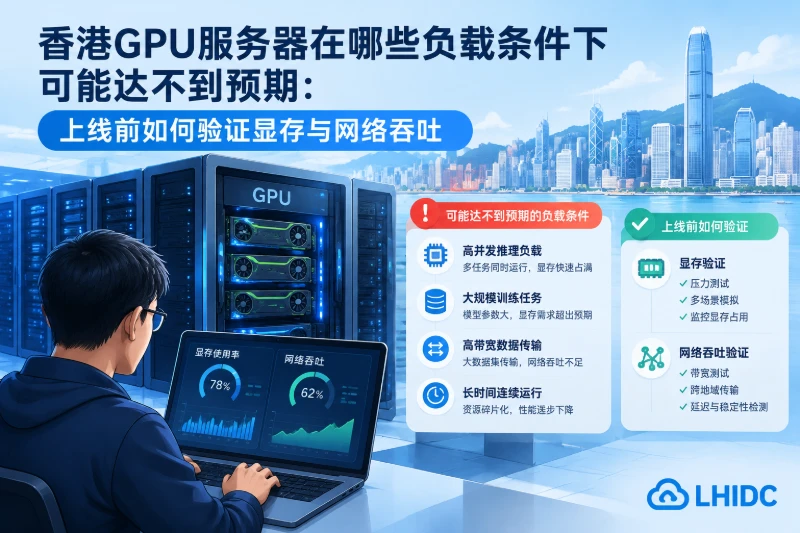
香港GPU服务器是否能达到预期,不能只看GPU型号、显存容量或标称带宽。真正容易暴露问题的场景通常是:模型权重、激活值或KV Cache接近显存上限;任务频繁在CPU与GPU之间搬运数据;训练数据需要跨网络持续读取;推理请求来自远端且对延迟、丢包敏感;单连接吞吐又被往返时延和TCP窗口限制。
上线前应使用接近生产的模型规模、批量、并发和数据路径进行验证,并固定测试节点、时段、网络方向及软件版本。单次跑满GPU或一次测速数字,只能说明当时环境,不足以代表长期业务表现。
先区分“显存容量”和“显存吞吐”
这两个指标经常被混为一谈:
- 显存容量:决定模型、缓存和中间数据能否同时放入GPU。容量不足通常表现为CUDA Out of Memory、批量无法提高或任务被迫转到CPU。
- 显存吞吐:表示GPU读写显存的效率。即使容量够用,算子如果大量搬运数据而计算量较低,也可能受内存带宽限制。
- GPU利用率:只能反映采样时段内GPU是否忙碌,不能单独证明计算效率高。
- 网络吞吐:应关注应用实际可用的有效吞吐,而不是只看网卡速率或端口带宽。
- 延迟、抖动与丢包:会影响TCP吞吐、分布式训练同步和在线推理响应,必须与吞吐一起记录。
nvidia-smi中的memory.used表示已占用容量,而utilization.memory通常表示显存读写活动程度,并不是以GB/s表示的真实带宽。判断是否受显存带宽限制,还需要结合框架Profiler或GPU分析工具观察算子。
哪些负载条件下容易达不到预期
模型能加载,但峰值阶段显存溢出
不能只用模型文件大小估算显存。推理还可能包含框架开销、临时张量和KV Cache;训练还涉及梯度、优化器状态、激活值及通信缓冲区。
基础估算可以从以下关系开始:
权重显存 ≈ 参数量 × 单参数字节数
峰值显存 ≈ 权重 + 激活值 + 缓存 + 临时工作区 + 框架保留空间
训练使用的优化器、精度、梯度检查点和并行方式不同,额外占用差异较大,不宜套用固定倍数。大语言模型推理中,KV Cache还会随上下文长度、批量和并发增加。短文本单请求能够运行,不代表最大上下文和生产并发也能运行。
GPU在等待数据,而不是执行计算
如果数据从远端对象存储、数据库或用户侧持续传入,网络吞吐不足会让GPU间歇空闲。典型表现是GPU利用率呈锯齿波动,显存已经分配,但计算利用率长期不高。
另一种情况是CPU预处理、磁盘读取或PCIe传输成为瓶颈。此时提高外部带宽未必有效,需要同步观察CPU、磁盘和网络,避免把所有低利用率都归因于GPU。
单连接无法获得预期网络吞吐
跨网络路径的往返时延、丢包、拥塞控制和接收窗口都会影响单条TCP连接。多连接测速明显高于单连接时,说明总链路可能仍有余量,但单会话业务未必能用满。
对于香港GPU服务器,测试源必须来自真实用户或数据源所在网络。仅在机房附近节点测速,不能代表远端训练数据上传、API访问或模型输出下载的体验。上行和下行也应分别验证,不能用一个方向代替另一个方向。
建立可复现的测试环境
测试前记录以下条件,后续复测必须尽量保持一致:
- GPU可见数量、显存容量,以及是否启用了MIG、vGPU或容器资源限制;
- NVIDIA驱动、CUDA、深度学习框架和模型版本;
- 模型精度、批量、序列长度、并发数及输入数据尺寸;
- 网络探针位置、运营网络、测试方向和测试时段;
- 是否经过代理、负载均衡、VPN、TLS或应用网关;
- 同期是否有其他任务占用GPU、CPU、磁盘或网络。
Linux环境可先用以下命令核对GPU状态。不同驱动版本支持的查询字段可能不同,执行前可用nvidia-smi --help-query-gpu确认:
nvidia-smi
nvidia-smi --query-gpu=name,memory.total,memory.used,utilization.gpu,utilization.memory,power.draw,temperature.gpu --format=csv -l 1
该操作只读取状态,不修改配置。测试期间应保存带时间戳的监控记录,并与应用日志中的请求或训练步骤对齐。
用真实负载验证显存峰值
最可靠的方法不是单纯申请一块大显存,而是运行生产模型,并逐级提高负载:
- 使用目标模型、精度和运行框架完成预热。
- 从基础批量与并发开始,记录稳定运行时的显存占用。
- 逐步增加批量、上下文长度或并发,每次只改变一个变量。
- 覆盖启动、首次编译、峰值请求和长时间运行阶段。
- 记录OOM、延迟突增、吞吐下降时对应的参数组合。
PyTorch任务可在业务代码的关键阶段读取峰值。下列代码需要放在目标工作负载前后,不能脱离实际模型单独得出容量结论:
import torch

torch.cuda.reset_peak_memory_stats()

# 在这里执行预热和代表生产峰值的训练或推理负载

torch.cuda.synchronize()
print("allocated_peak_GiB:",
      torch.cuda.max_memory_allocated() / 1024**3)
print("reserved_peak_GiB:",
      torch.cuda.max_memory_reserved() / 1024**3)
allocated是张量实际分配量,reserved包含框架缓存池保留空间。若只有峰值组合发生OOM,应先评估减小批量、缩短上下文、量化、梯度检查点或模型分片,而不是只依据空闲状态下的显存数字判断服务器不达标。
验证网络吞吐及双向差异
iperf3适合验证两台受控主机之间的TCP能力。测试会产生实际流量,必须获得两端管理权限,并避开生产高峰,避免影响在线业务。
服务端运行:
iperf3 -s
香港GPU服务器作为客户端时,可分别测试单连接、多连接和反向流量:
iperf3 -c <受控测试端地址> -P 1 -t 30 --get-server-output
iperf3 -c <受控测试端地址> -P 4 -t 30 --get-server-output
iperf3 -c <受控测试端地址> -P 4 -t 30 -R --get-server-output
测试端应部署在真实业务数据源或用户侧网络附近,而不是随意选择一个公网测速节点。测试完成后建议按统一口径记录:
| 测试节点 | 时段 | 方向 | 并发流数 | 平均延迟 | 延迟范围 | 丢包情况 | TCP有效吞吐 |
|---|---|---|---|---|---|---|---|
| 业务数据源侧探针 | 待记录 | 上传至服务器 | 待记录 | 待记录 | 待记录 | 待记录 | 待记录 |
| 业务用户侧探针 | 待记录 | 服务器下行 | 待记录 | 待记录 | 待记录 | 待记录 | 待记录 |
如需定位路径波动,可使用mtr进行持续观察:
mtr -rwzc 100 <受控测试端地址>
中间节点可能限制或降低ICMP响应优先级,因此某一跳显示丢包、而后续节点正常时,不能直接认定该节点存在业务丢包。应重点查看最终目标,并结合iperf3重传、应用超时和服务端网卡统计判断。
如何解释异常结果
| 观察结果 | 更可能的限制 | 下一步验证 |
|---|---|---|
| 显存接近上限并出现OOM | 模型、激活值或缓存容量不足 | 固定模型,分别降低批量、上下文和并发 |
| 显存占用较高但GPU利用率间歇下降 | 数据供应、CPU预处理或同步等待 | 同时记录CPU、磁盘、网络与批次耗时 |
| GPU利用率高但业务吞吐增长有限 | 算子、显存带宽或计算能力受限 | 使用框架Profiler查看耗时算子 |
| 多连接吞吐明显高于单连接 | RTT、TCP窗口或单流处理能力限制 | 按业务真实连接数复测 |
| 正向与反向吞吐差异明显 | 双向路径、拥塞或端点处理能力不同 | 交换客户端与服务端并在另一时段复测 |
| 网络测速正常但应用传输慢 | TLS、代理、协议、序列化或存储限制 | 绕过非必要中间层做对照测试 |
复测后再确定上线边界
有效的验收结果应同时写明测试节点、网络路径、时间、持续时长、负载参数和软件版本。至少在低峰与业务高峰各执行一组重复测试,并保留一次单变量对照,例如只改变并发数或只改变数据源位置。
只有当最大生产负载下显存没有异常增长、GPU无持续等待数据现象、网络有效吞吐能够支撑实际数据量,并且重复测试结果具有一致性时,才能把该配置纳入上线范围。路由变化、共享链路负载、模型版本升级及输入长度变化都可能使原有数字失效,因此测试结果应被视为特定条件下的容量边界,而不是香港GPU服务器长期性能的无条件承诺。